Web LLM Attacks چیست؟ امنیت سایتها و اپلیکیشنهای متصل به هوش مصنوعی
Web LLM Attacks به حملاتی گفته میشود که سایتها و اپلیکیشنهای متصل به مدلهای زبانی بزرگ را از طریق Prompt، RAG، ابزارهای متصل، APIها یا خروجی هوش مصنوعی هدف قرار میدهند. Prompt Injection، نشت اطلاعات حساس، Excessive Agency و ضعف Vector Database از مهمترین خطرات این معماریها هستند. مقابله با Web LLM Attacks به کنترل دسترسی مستقل، Least Privilege، جداسازی دادهها، اعتبارسنجی ورودی و خروجی، محدودسازی Toolها و مانیتورینگ مستمر نیاز دارد.

پاسخ کوتاه: Web LLM Attacks به مجموعه حملاتی گفته میشود که سامانههای وب متصل به مدلهای زبانی بزرگ یا LLM را هدف میگیرند. در این حملات، مهاجم ممکن است ورودی مدل، دادههای RAG، ابزارهای متصل، APIها، حافظه مکالمه یا خروجی هوش مصنوعی را دستکاری کند تا مدل اطلاعات محرمانه افشا کند، دستورهای ناخواسته اجرا کند، به دادههای دیگر کاربران دسترسی پیدا کند یا رفتار اپلیکیشن را تغییر دهد. دفاع مؤثر در برابر Web LLM Attacks به ترکیبی از کنترل دسترسی، جداسازی داده، Least Privilege، اعتبارسنجی ورودی و خروجی، محدودسازی Toolها، مانیتورینگ و معماری امن نیاز دارد.
مقدمه؛ وقتی هوش مصنوعی به بخشی از سطح حمله وب تبدیل میشود
اضافه کردن یک چتبات هوشمند به سایت در ظاهر ممکن است فقط شبیه اضافه کردن یک قابلیت جدید باشد؛ کاربر سؤال میپرسد، درخواست به یک مدل زبانی ارسال میشود و پاسخ مدل در صفحه نمایش داده میشود. اما معماری واقعی بسیاری از سرویسهای مبتنی بر هوش مصنوعی بسیار پیچیدهتر از این سناریوی ساده است.
یک LLM ممکن است به پایگاه دانش شرکت متصل باشد، اطلاعات کاربران را از دیتابیس دریافت کند، فایل بخواند، ایمیل تولید کند، به CRM دسترسی داشته باشد، وضعیت سفارش را بررسی کند، از APIهای داخلی استفاده کند یا حتی بهصورت Agent درباره اجرای ابزارهای مختلف تصمیم بگیرد.
در چنین معماریای، مدل دیگر فقط یک «مولد متن» نیست. LLM به نقطهای میان کاربر، داده و قابلیتهای حساس سیستم تبدیل میشود.
همین مسئله مفهوم Web LLM Attacks را مهم میکند.
در امنیت کلاسیک وب، توسعهدهنده معمولاً میداند یک ورودی قرار است به کجا برسد. برای مثال مقدار یک فرم ممکن است وارد SQL Query، HTML، فایل سیستم یا API شود و برای هر Context میتوان کنترل امنیتی مشخصی در نظر گرفت.
اما در اپلیکیشنهای LLM محور، یک متن طبیعی میتواند ابتدا وارد مدل شود، سپس مدل آن را تفسیر کند، از یک منبع خارجی داده بگیرد، یک Tool فراخوانی کند و خروجی Tool دوباره وارد Context مدل شود. نتیجه نهایی نیز ممکن است در مرورگر نمایش داده شود یا وارد یک سیستم دیگر شود.
یعنی یک ورودی ظاهراً ساده ممکن است از چند Trust Boundary عبور کند.
مشکل دیگر این است که LLMها دستور، داده و محتوای غیرقابل اعتماد را مانند یک Parser سنتی با مرزهای کاملاً قطعی از یکدیگر جدا نمیکنند. متنی که توسعهدهنده تصور میکند فقط «محتوا» است، ممکن است برای مدل شبیه «دستور» تفسیر شود.
به همین دلیل امنیت سایتهای متصل به هوش مصنوعی را نمیتوان صرفاً با یک System Prompt قوی، یک فیلتر کلمات یا یک WAF سنتی حل کرد.
معماری باید از ابتدا بر این فرض طراحی شود که مدل ممکن است اشتباه کند، تحت تأثیر ورودی مخرب قرار بگیرد یا خروجی غیرمنتظره تولید کند.
Web LLM Attacks چیست؟
Web LLM Attacks یک نام کلی برای حملاتی است که از نحوه ادغام Large Language Modelها با اپلیکیشنهای وب سوءاستفاده میکنند.
هدف حمله الزاماً خود مدل هوش مصنوعی نیست. در بسیاری از موارد مهاجم از LLM بهعنوان مسیری برای رسیدن به بخشهای دیگر سیستم استفاده میکند.
برای مثال ممکن است هدف واقعی یکی از موارد زیر باشد:
- اطلاعات محرمانه کاربران
- System Prompt
- اسناد داخلی سازمان
- پایگاه داده
- APIهای خصوصی
- ابزارهای متصل به Agent
- حساب کاربری سایر کاربران
- فایلهای ذخیرهشده
- منابع پردازشی و هزینه API
- سیستمهای داخلی شرکت
- دادههای موجود در Vector Database
- سرویسهای شخص ثالث
بنابراین هنگام بررسی Web LLM Attacks باید کل زنجیره پردازش درخواست را بررسی کرد، نه فقط مدل زبانی را.
OWASP در دستهبندی ریسکهای امنیتی LLM و GenAI مواردی مانند Prompt Injection، افشای اطلاعات حساس، Supply Chain، Data and Model Poisoning، Improper Output Handling، Excessive Agency، System Prompt Leakage، ضعف Vector و Embedding، Misinformation و Unbounded Consumption را از ریسکهای مهم این نوع سامانهها میداند.
تفاوت Web LLM Attacks با حملات سنتی وب چیست؟
حملات سنتی وب همچنان در اپلیکیشنهای مبتنی بر هوش مصنوعی وجود دارند.
یک سایت دارای LLM هنوز ممکن است در برابر مواردی مانند زیر آسیبپذیر باشد:
- XSS
- CSRF
- SQL Injection
- SSRF
- IDOR
- Broken Access Control
- Path Traversal
- Command Injection
- ضعف احراز هویت
- Session Management ضعیف
هوش مصنوعی این آسیبپذیریها را حذف نمیکند.
تفاوت اصلی در این است که LLM یک لایه تصمیمگیری و پردازش غیرقطعی به معماری اضافه میکند.
در یک برنامه معمولی ممکن است Backend تصمیم بگیرد:
«اگر کاربر Admin نیست، این عملیات اجرا نشود.»
اما در طراحی ناامن مبتنی بر LLM ممکن است توسعهدهنده عملاً از مدل بخواهد تصمیم بگیرد:
«اگر فکر میکنی کاربر مجاز است، Tool مربوط به عملیات مدیریتی را اجرا کن.»
این دو طراحی از نظر امنیتی تفاوت بنیادی دارند.
Authorization باید توسط کد و سرویسهای قابل اعتماد انجام شود؛ مدل نباید مرجع نهایی تصمیمات امنیتی باشد. 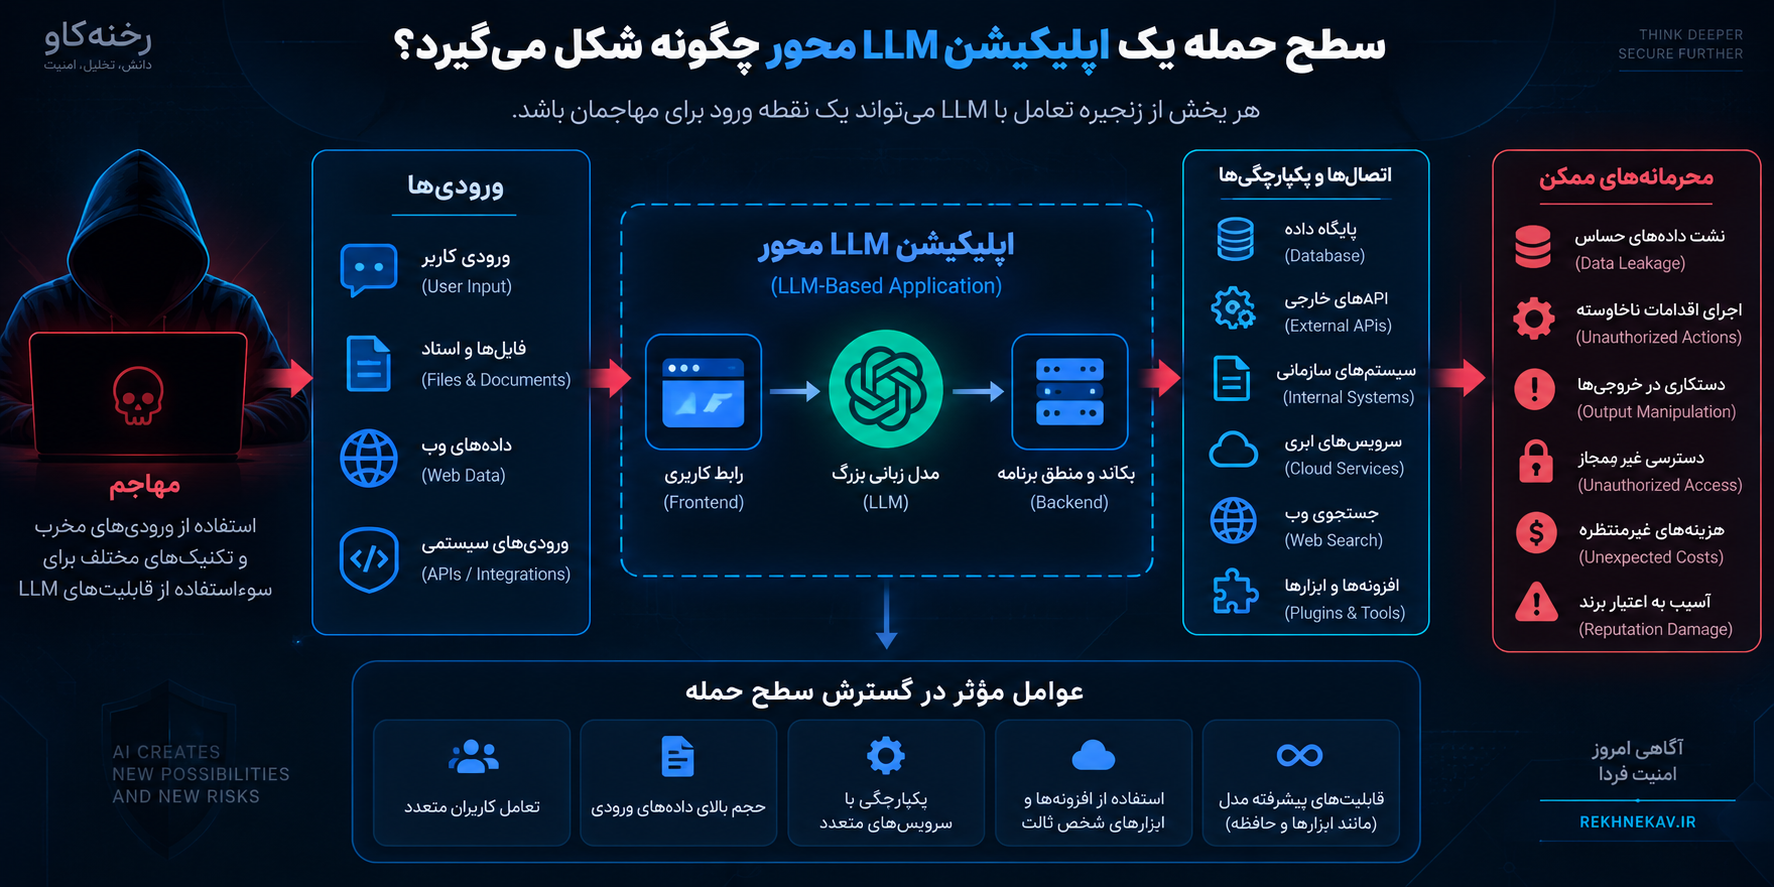
سطح حمله یک اپلیکیشن LLM محور چگونه شکل میگیرد؟
برای تحلیل Web LLM Attacks ابتدا باید اجزای معماری را شناسایی کنیم.
یک سیستم رایج ممکن است چنین مسیر مفهومی داشته باشد:
کاربر ← رابط وب ← Backend ← LLM ← RAG ← Vector Database ← Tool/API ← سرویس داخلی
اما در عمل مسیرهای بیشتری نیز وجود دارند.
برای مثال:
فایل کاربر → Parser → Embedding → Vector Database → Retriever → LLM
یا:
صفحه وب خارجی → Crawler → Knowledge Base → LLM Agent
یا:
LLM → Tool Selection → API Gateway → CRM / Email / Database
هر فلش در این معماری میتواند یک Trust Boundary باشد.
اگر دادهای از محیطی با اعتماد کمتر وارد محیطی با دسترسی بیشتر شود، باید مشخص باشد چه کنترل امنیتی قبل و بعد از آن اعمال میشود.
مهمترین اجزای سطح حمله
سطح حمله معمولاً شامل این بخشهاست:
- Prompt کاربر
- System Prompt
- Conversation History
- حافظه بلندمدت Agent
- اسناد آپلودشده
- صفحات وب بازیابیشده
- RAG Pipeline
- Embedding Model
- Vector Database
- Pluginها و Toolها
- APIهای داخلی
- خروجی LLM
- مرورگر کاربر
- سرویسهای شخص ثالث
- سیستم Logging و Analytics
نادیده گرفتن هرکدام از این بخشها میتواند باعث ایجاد یک مسیر حمله جدید شود. 
Prompt Injection چیست و چرا یکی از مهمترین Web LLM Attacks است؟
Prompt Injection زمانی رخ میدهد که ورودی بتواند رفتار مورد انتظار مدل را تغییر دهد.
برای مثال توسعهدهنده انتظار دارد مدل صرفاً به سؤالات مربوط به محصولات پاسخ دهد، اما محتوایی وارد Context میشود که تلاش میکند اولویت دستورها یا رفتار مدل را تغییر دهد.
Prompt Injection از جهاتی با Injectionهای کلاسیک متفاوت است.
در SQL Injection مهاجم تلاش میکند مرز میان Data و SQL Code را بشکند.
در Prompt Injection نیز مسئله اصلی این است که مدل همیشه نمیتواند مرز میان «دادهای که باید تحلیل شود» و «دستوری که باید اجرا شود» را بهطور مطمئن تشخیص دهد.
طبق راهنمای امنیتی OWASP، Prompt Injection میتواند مستقیم یا غیرمستقیم باشد و RAG یا Fine-Tuning بهتنهایی این مشکل را بهطور کامل برطرف نمیکنند.
Direct Prompt Injection چیست؟
در Direct Prompt Injection، خود کاربر محتوایی را مستقیماً برای مدل ارسال میکند که هدف آن تغییر رفتار مورد انتظار سیستم است.
در یک چتبات معمولی این ورودی میتواند از طریق:
- Textarea
- Chat Interface
- API
- فرم پشتیبانی
- فایل آپلودی
- پیام صوتی تبدیلشده به متن
وارد سیستم شود.
خطر واقعی زمانی افزایش مییابد که مدل علاوه بر پاسخ متنی، قابلیت انجام عملیات نیز داشته باشد.
اگر یک مدل فقط متن عمومی تولید کند، دامنه خسارت محدودتر است.
اما اگر همان مدل بتواند:
- فایل بخواند،
- ایمیل ارسال کند،
- سفارش تغییر دهد،
- اطلاعات CRM را مشاهده کند،
- Query ایجاد کند،
- یا Toolهای مدیریتی اجرا کند،
Prompt Injection میتواند به مسئلهای بسیار جدیتر تبدیل شود.
Indirect Prompt Injection چیست؟
Indirect Prompt Injection یکی از مهمترین تهدیدات اپلیکیشنهای مدرن LLM است.
در این حالت مهاجم الزاماً مستقیماً با چتبات صحبت نمیکند.
بهجای آن، دستور مخرب در منبعی قرار میگیرد که مدل بعداً آن را میخواند.
برای مثال یک Agent ممکن است داده را از:
- یک صفحه وب
- فایل PDF
- سند سازمانی
- ایمیل
- Ticket پشتیبانی
- Review محصول
- مخزن کد
- Knowledge Base
دریافت کند.
اگر مدل محتوای بازیابیشده را بهعنوان بخشی از Context پردازش کند، دستور موجود در آن محتوا ممکن است روی رفتار مدل اثر بگذارد.
NIST نیز Direct و Indirect Prompt Injection را از ریسکهای امنیتی سامانههای Generative AI مطرح میکند و به خطر تأثیر ورودیهای دستکاریشده بر سیستمهای متصل اشاره دارد.
چرا فیلتر کردن چند عبارت مشکل را حل نمیکند؟
یکی از اشتباهات رایج توسعهدهندگان ساخت یک Blacklist از عبارتهای مشکوک است.
برای مثال تصور میشود اگر چند جمله شناختهشده مرتبط با تغییر دستورهای مدل مسدود شود، Prompt Injection حل شده است.
اما زبان طبیعی تقریباً بینهایت شکل بیان دارد.
محتوا همچنین ممکن است:
- چندزبانه باشد،
- Encode شده باشد،
- داخل سند قرار گرفته باشد،
- از چند منبع ترکیب شده باشد،
- داخل تصویر باشد،
- یا بدون عبارتهای واضح رفتار مدل را تغییر دهد.
بنابراین Input Filtering مفید است، اما نباید کنترل اصلی امنیت باشد.
اصل مهمتر این است:
حتی اگر Prompt Injection موفق شد، مدل نباید اختیار و دسترسی لازم برای ایجاد خسارت جدی را داشته باشد.
Prompt Injection در سیستمهای Multimodal
مدلهای جدید فقط متن پردازش نمیکنند.
ممکن است ورودی شامل:
- تصویر
- صوت
- ویدئو
- Screenshot
- Document
باشد.
این مسئله سطح Prompt Injection را گسترش میدهد.
برای مثال ممکن است متنی در تصویری قرار گرفته باشد که برای انسان بخشی از محتوای عادی به نظر برسد اما مدل آن را بهعنوان دستور پردازش کند.
در نتیجه هنگام طراحی سامانه Multimodal نباید فقط Text Input بررسی شود.
تمام Modalities ورودی باید بهعنوان داده بالقوه غیرقابل اعتماد در نظر گرفته شوند. OWASP نیز اشاره میکند که سیستمهای Multimodal میتوانند مسیرهای جدید Prompt Injection ایجاد کنند. 
System Prompt Leakage چیست؟
System Prompt مجموعه دستورهایی است که معمولاً رفتار پایه مدل را تعیین میکند.
برای مثال ممکن است شامل موارد زیر باشد:
- نقش مدل
- محدودیتهای رفتاری
- قالب خروجی
- اطلاعات مربوط به Toolها
- قواعد داخلی برنامه
- نحوه پاسخ به کاربران
یکی از اهداف رایج در بررسی Web LLM Attacks تلاش برای استخراج System Prompt است.
اما نکته امنیتی بسیار مهم این است که System Prompt نباید بهعنوان Secret یا Security Boundary در نظر گرفته شود.
اگر امنیت سیستم فقط به مخفی ماندن Prompt وابسته باشد، معماری از ابتدا مشکل دارد.
OWASP نیز تأکید میکند که System Prompt نباید محل نگهداری Credential، Connection String یا اطلاعات حساس باشد و نباید جایگزین Authorization واقعی شود.
چه اطلاعاتی نباید داخل System Prompt قرار گیرد؟
بهتر است مواردی مانند اینها هرگز داخل Prompt ذخیره نشوند:
- API Key
- Password
- Database Credential
- Access Token
- Secret Key
- Token سرویس شخص ثالث
- اطلاعات خصوصی کاربران
- اطلاعات احراز هویت
- کلیدهای رمزنگاری
همچنین قوانینی مانند:
«کاربران عادی اجازه مشاهده این اطلاعات را ندارند»
نباید تنها کنترل امنیتی سیستم باشند.
Backend باید مستقل از مدل بررسی کند که کاربر برای دسترسی به Resource موردنظر مجاز است یا خیر.
Sensitive Information Disclosure؛ نشت اطلاعات حساس
یکی دیگر از تهدیدات مهم Web LLM Attacks افشای اطلاعات حساس است.
LLM ممکن است به دادههایی دسترسی داشته باشد که کاربر نباید آنها را مشاهده کند.
این اطلاعات میتواند شامل:
- PII یا اطلاعات هویتی
- ایمیل و شماره تلفن
- اطلاعات مالی
- اطلاعات پزشکی
- اسناد داخلی
- قراردادها
- اطلاعات تجاری محرمانه
- Credential
- Token
- داده سایر مشتریان
باشد.
OWASP افشای Sensitive Information را یکی از ریسکهای اصلی اپلیکیشنهای LLM معرفی میکند.
نشت داده همیشه از خود مدل نیست
گاهی توسعهدهنده تصور میکند اگر Provider هوش مصنوعی دادهها را ذخیره نکند، خطر نشت اطلاعات برطرف شده است.
اما نشت میتواند در لایههای دیگر رخ دهد.
برای مثال:
RAG Retriever ممکن است سند کاربر دیگری را بازیابی کند.
Vector Search ممکن است Tenant Filter صحیح نداشته باشد.
Conversation History ممکن است بین Sessionها اشتباه Cache شود.
Logging ممکن است Prompt و Response حاوی اطلاعات حساس را ذخیره کند.
بنابراین Data Leakage باید در کل Pipeline بررسی شود.
خطر Cross-Tenant Data Leakage
در SaaSهایی که چند مشتری از یک زیرساخت مشترک استفاده میکنند، جداسازی داده اهمیت بسیار بیشتری دارد.
فرض کنید اسناد شرکت A و شرکت B داخل یک Vector Database نگهداری میشوند.
اگر Retriever فقط براساس Similarity Search عمل کند و Tenant ID در سطح Backend بهصورت سختگیرانه اعمال نشود، ممکن است سند شرکت B برای سؤال شرکت A بازیابی شود.
در این وضعیت حتی اگر LLM کاملاً مطابق دستور عمل کند، داده اشتباه در اختیار مدل قرار گرفته است.
بنابراین مشکل اصلی Prompt نیست.
مشکل Broken Access Control در لایه Retrieval است.
در معماری امن باید Authorization قبل از ورود داده به Context مدل اعمال شود.
Improper Output Handling چیست؟
یکی از خطرناکترین اشتباهات این است که خروجی LLM «قابل اعتماد» در نظر گرفته شود.
مدل یک Security Component نیست.
خروجی آن باید مانند دادهای غیرقابل اعتماد بررسی شود.
اگر خروجی مدل بدون Validation وارد سیستم دیگری شود، Web LLM Attack ممکن است به آسیبپذیری سنتی وب تبدیل شود.
OWASP هشدار میدهد Improper Output Handling میتواند بسته به محل استفاده خروجی به پیامدهایی مانند XSS، CSRF، SSRF، Privilege Escalation یا حتی Remote Code Execution منجر شود.
خروجی LLM نباید مستقیماً وارد HTML شود
فرض کنید مدل Markdown یا HTML تولید میکند و Frontend خروجی را بدون Sanitization نمایش میدهد.
در چنین معماریای محتوایی که مدل تولید کرده ممکن است به یک مسئله XSS تبدیل شود.
راهکار صحیح استفاده از:
- Context-Aware Output Encoding
- HTML Sanitization
- Markdown Renderer امن
- Content Security Policy
- محدود کردن Tagها و Attributeهای مجاز
است.
خروجی LLM نباید مستقیماً Query اجرایی شود
در برخی پروژهها از LLM برای تبدیل زبان طبیعی به Query استفاده میشود.
برای مثال:
کاربر سؤال میپرسد → مدل Query تولید میکند → Query اجرا میشود.
اگر خروجی مدل مستقیماً در SQL، Shell، Template Engine یا سایر Interpreterها اجرا شود، ریسک بسیار بالاست.
مدل باید در بهترین حالت یک پیشنهاد ساختاریافته تولید کند و Backend مجاز بودن عملیات را مستقل بررسی کند.
در موارد حساس، طراحی Allowlist-Based بسیار امنتر از پذیرفتن خروجی آزاد مدل است. 
Excessive Agency؛ وقتی هوش مصنوعی بیش از حد اختیار دارد
ظهور AI Agentها یکی از مهمترین تغییرات امنیتی در این حوزه است.
Agent فقط پاسخ نمیدهد.
ممکن است تصمیم بگیرد:
- کدام Tool اجرا شود،
- چه اطلاعاتی خوانده شود،
- چه API فراخوانی شود،
- چه فایلی تغییر کند،
- چه پیامی ارسال شود.
این توانایی مفید است، اما اگر بیش از حد گسترده باشد، مفهوم Excessive Agency مطرح میشود.
OWASP سه ریشه مهم برای Excessive Agency بیان میکند:
- Excessive Functionality
- Excessive Permissions
- Excessive Autonomy
یعنی مدل قابلیتهای بیش از حد لازم داشته باشد، مجوزهایش بیش از حد باشد یا بدون کنترل کافی بتواند عملیات انجام دهد.
اصل Least Privilege برای AI Agent
یک Agent پشتیبانی که فقط باید وضعیت سفارش را مشاهده کند، نباید Tokenی داشته باشد که امکان:
- حذف سفارش،
- تغییر قیمت،
- بازپرداخت وجه،
- تغییر حساب مشتری
را نیز فراهم کند.
حتی اگر System Prompt نوشته باشد:
«هیچوقت سفارش را حذف نکن.»
این محدودیت امنیتی قابل اتکایی نیست.
Credential مورد استفاده Agent باید فقط Scope مورد نیاز را داشته باشد.
Human-in-the-Loop برای عملیات حساس
برخی عملیات نباید فقط براساس تصمیم مدل انجام شوند.
برای مثال:
- انتقال پول
- حذف داده
- تغییر Permission
- تغییر Credential
- انتشار عمومی محتوا
- ارسال حجم بالای پیام
- تغییرات مدیریتی
میتوانند به تأیید صریح انسان نیاز داشته باشند.
الگوی امن این است که Agent عملیات را پیشنهاد دهد، اما اجرای مرحله حساس پس از Authorization و Confirmation مستقل انجام شود.
Tool Calling چگونه سطح حمله را افزایش میدهد؟
Function Calling یا Tool Calling به مدل اجازه میدهد از قابلیتهای خارجی استفاده کند.
در یک معماری امن Tool باید مانند یک API واقعی طراحی شود.
یعنی دارای:
- Authentication
- Authorization
- Schema Validation
- Rate Limiting
- Logging
- Error Handling
- محدودیت Scope
باشد.
نباید فرض کرد چون Tool فقط توسط LLM فراخوانی میشود، دیگر نیازی به کنترل امنیتی ندارد.
برعکس، Tool Endpoint باید فرض کند Caller ممکن است درخواست اشتباه یا دستکاریشده ارسال کند.
مدل نباید تعیینکننده نهایی Permission باشد
سناریوی ناامن:
LLM تشخیص دهد کاربر Admin است و سپس عملیات مدیریتی اجرا شود.
سناریوی امن:
Backend هویت و Permission کاربر را بررسی کند و فقط Toolهای مجاز همان User Context را در اختیار Agent قرار دهد.
Authorization باید Deterministic باشد. 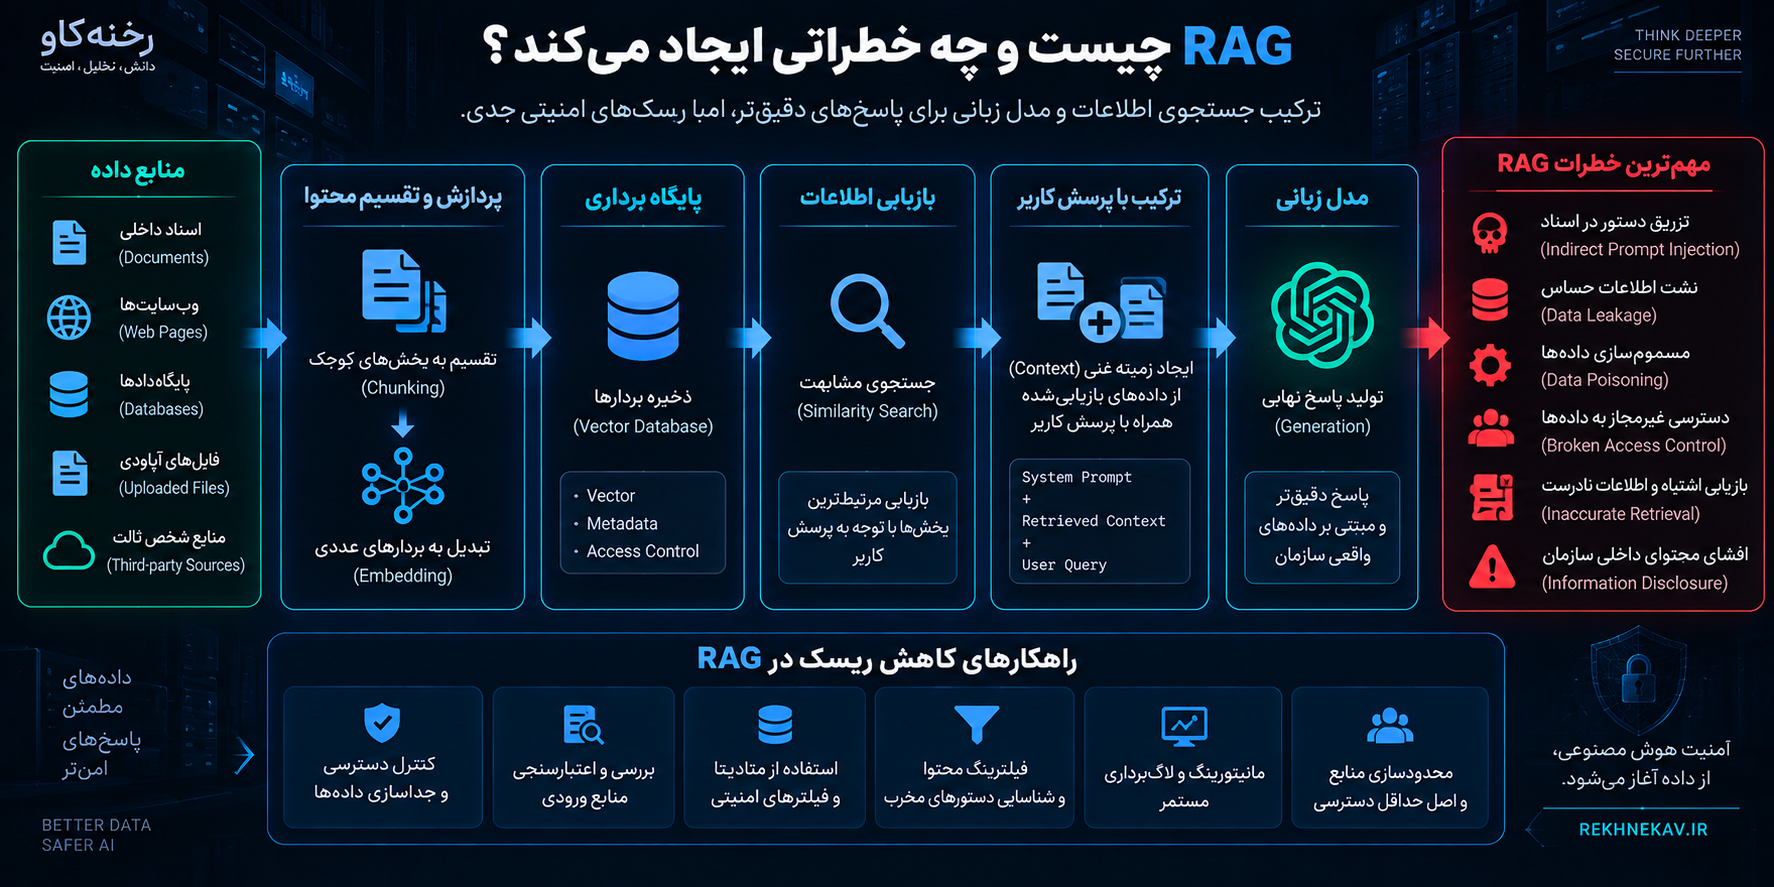
RAG چیست و چه خطراتی ایجاد میکند؟
Retrieval-Augmented Generation یا RAG روشی است که در آن LLM قبل از پاسخ، اطلاعات مرتبط را از یک منبع خارجی دریافت میکند.
این منبع ممکن است:
- اسناد شرکت
- مقالات
- فایلها
- FAQ
- Database
- Wiki داخلی
- Vector Store
باشد.
RAG باعث افزایش کاربرد مدل میشود، اما همزمان سطح حمله جدیدی ایجاد میکند.
Vector and Embedding Weaknesses
در معماری RAG معمولاً محتوا به Embedding تبدیل و در Vector Database ذخیره میشود.
سپس براساس Similarity، Chunkهای مرتبط بازیابی میشوند.
ضعف در این لایه میتواند باعث:
- بازیابی اطلاعات غیرمجاز
- Cross-Tenant Leakage
- ورود محتوای Poisoned
- بازیابی اسناد نامعتبر
- ترکیب Contextهای متعلق به منابع مختلف
شود.
OWASP ضعفهای Vector و Embedding را بهطور خاص یکی از ریسکهای سامانههای RAG میداند و به خطر دسترسی غیرمجاز، نشت داده و Poisoning اشاره میکند.
RAG Poisoning چیست؟
فرض کنید یک Knowledge Base از منابعی ساخته میشود که برخی کاربران قادر به ویرایش آن هستند.
اگر مهاجم بتواند محتوایی وارد این منابع کند که بعداً توسط Retriever انتخاب شود، ممکن است پاسخهای مدل را تحت تأثیر قرار دهد.
به این مسئله میتوان در قالب Data Poisoning یا RAG Poisoning نگاه کرد.
راهکار تنها اسکن کلمات مشکوک نیست.
باید مشخص شود:
- چه کسی اجازه افزودن Source دارد؟
- Source از کجا آمده است؟
- چه کسی آن را تأیید کرده؟
- چه زمانی تغییر کرده است؟
- آیا محتوا Trusted است؟
- آیا داده مربوط به Tenant صحیح است؟
- آیا اسناد قدیمی حذف یا Versioning شدهاند؟
Data and Model Poisoning
Poisoning فقط به RAG محدود نیست.
دادههایی که برای:
- Training
- Fine-Tuning
- Embedding
- Knowledge Base
- Feedback Loop
استفاده میشوند نیز میتوانند آلوده شوند.
اگر سازمان بدون کنترل کیفیت، داده کاربران را مستقیماً وارد چرخه یادگیری یا Knowledge Base کند، مهاجم ممکن است تلاش کند دادههایی وارد سیستم کند که رفتار آینده مدل را تغییر دهد.
برای مقابله با این خطر باید Data Provenance وجود داشته باشد.
یعنی بتوان مشخص کرد هر Dataset یا Document:
از کجا آمده،
چه کسی آن را وارد کرده،
چه تغییراتی روی آن انجام شده،
و برای چه هدفی قابل استفاده است.
Supply Chain در اپلیکیشنهای هوش مصنوعی
اپلیکیشن LLM محور معمولاً از اجزای متعددی استفاده میکند:
- Foundation Model
- SDK
- Python Package
- JavaScript Library
- Embedding Model
- Plugin
- Vector Database
- Model Repository
- Prompt Template
- Dataset
- Container Image
هر کدام از این اجزا میتواند Supply Chain Risk ایجاد کند.
بنابراین مدیریت Dependencyها همچنان ضروری است.
اقداماتی مانند موارد زیر اهمیت دارند:
- Pin کردن Versionها
- بررسی Packageهای Third-Party
- Software Composition Analysis
- بررسی Model Source
- کنترل Hash یا Signature در صورت امکان
- محدود کردن Dependencyهای غیرضروری
- مدیریت Secretها خارج از Repository
استفاده از AI نباید باعث کنار گذاشتن اصول Secure Software Supply Chain شود.
Unbounded Consumption و حملات هزینهای
امنیت فقط Confidentiality نیست.
Availability و هزینه نیز اهمیت دارند.
LLM APIها میتوانند منابع قابلتوجهی مصرف کنند.
اگر محدودیتی برای:
- تعداد Request
- اندازه Prompt
- حجم فایل
- تعداد Tool Call
- تعداد Agent Step
- Context Length
- Generation Length
وجود نداشته باشد، مهاجم یا حتی یک Bug ممکن است مصرف منابع را شدیداً افزایش دهد.
در سرویسهای Cloud این موضوع میتواند علاوه بر اختلال سرویس، هزینه مالی ایجاد کند.
کنترلهای پیشنهادی
برای هر User یا API Key بهتر است محدودیتهایی مانند:
- Rate Limit
- Token Budget
- Daily Quota
- Maximum File Size
- Maximum Conversation Length
- Maximum Tool Invocations
- Agent Step Limit
- Timeout
تعریف شود.
همچنین افزایش غیرعادی مصرف باید Alert ایجاد کند.
خطر Misinformation و اعتماد بیش از حد
همه تهدیدهای LLM الزاماً نتیجه حمله مستقیم نیستند.
مدل ممکن است اطلاعات نادرست تولید کند.
در یک Chatbot عمومی شاید پیامد این موضوع محدود باشد.
اما اگر خروجی LLM در فرآیندهایی مانند:
- تحلیل امنیتی
- تصمیم مالی
- پاسخ حقوقی
- عملیات DevOps
- مدیریت مشتری
- تولید تنظیمات
استفاده شود، اعتماد بیش از حد میتواند خطرناک باشد.
راهکار مناسب بسته به Criticality سیستم متفاوت است.
در کاربردهای حساس باید:
- خروجی قابل راستیآزمایی باشد،
- Source یا Evidence در صورت نیاز مشخص باشد،
- عملیات حساس نیازمند تأیید باشد،
- مدل مرجع نهایی Authorization نباشد.
زنجیره حمله در Web LLM Attacks
خطر اصلی بسیاری از Web LLM Attacks در ترکیب چند ضعف ایجاد میشود.
ممکن است یک ضعف بهتنهایی شدت زیادی نداشته باشد، اما همراه شدن آن با ضعف دیگر به حمله جدی منجر شود.
یک زنجیره مفهومی میتواند چنین باشد:
محتوای غیرقابل اعتماد وارد RAG میشود.
↓
LLM تحت تأثیر آن محتوا قرار میگیرد.
↓
مدل Tool اشتباهی را انتخاب میکند.
↓
Tool دارای Permission بیش از حد است.
↓
Backend درخواست Tool را دوباره Authorization نمیکند.
↓
اطلاعات حساس برگردانده میشود.
↓
خروجی بدون فیلتر در پاسخ قرار میگیرد.
در چنین سناریویی سؤال اصلی این نیست که:
«چرا مدل دستور را رعایت نکرد؟»
سؤال درست این است:
«چرا شکست یک لایه توانست بدون مانع به شکست کامل سیستم تبدیل شود؟»
پاسخ، Defense in Depth است. 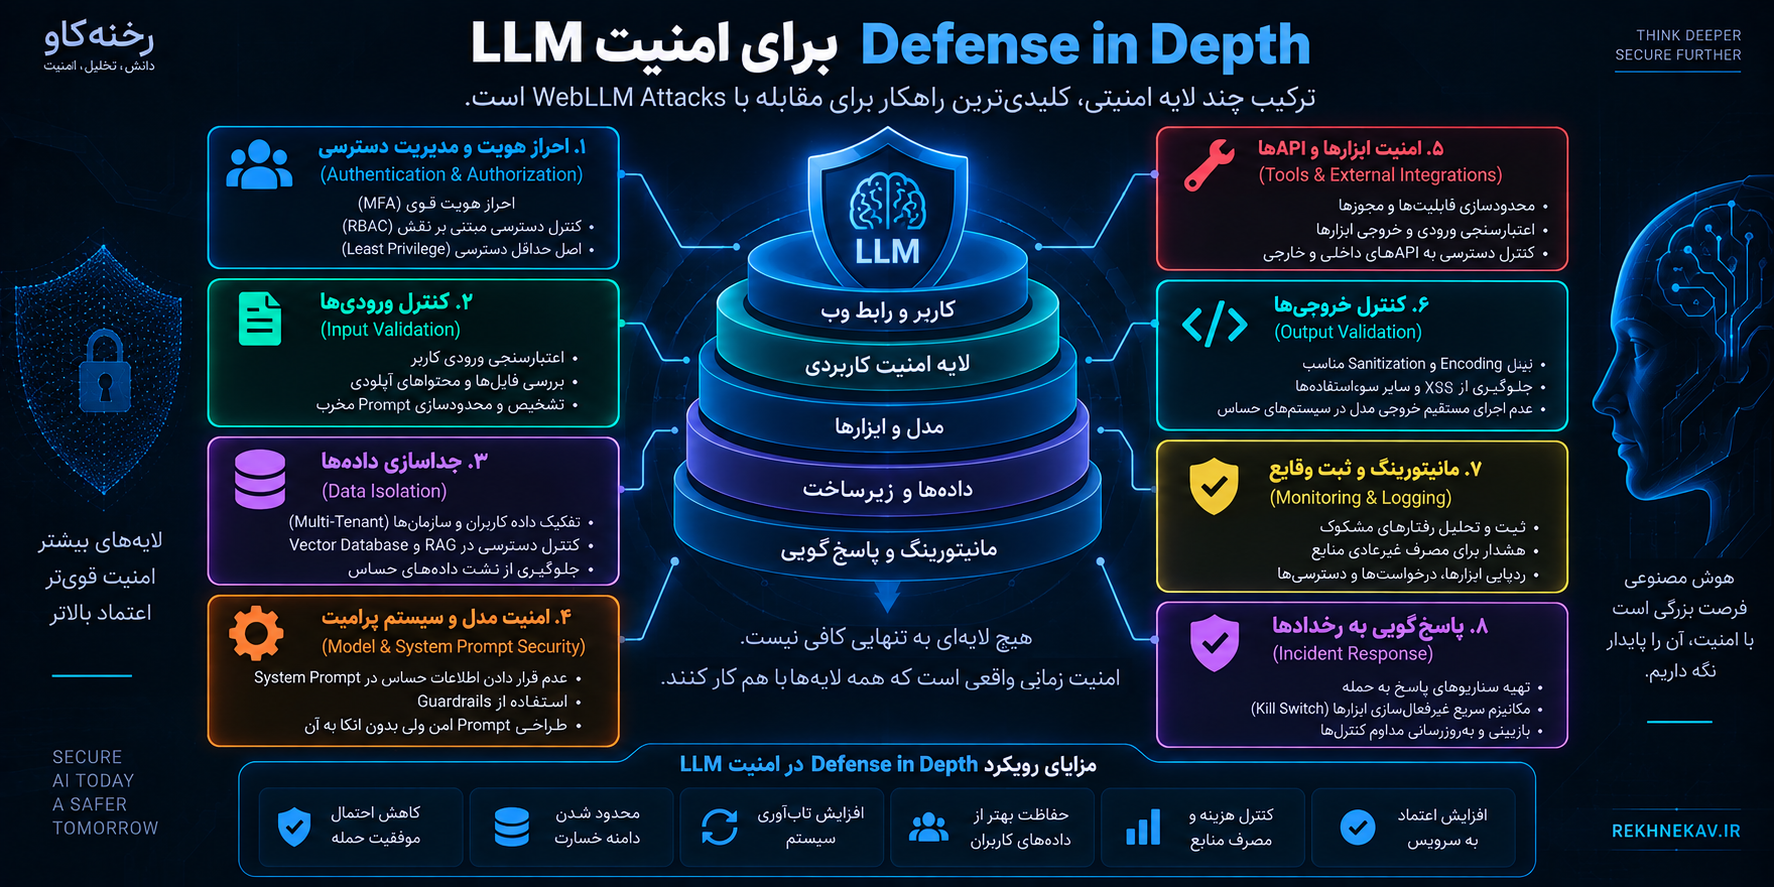
Defense in Depth برای امنیت LLM
امنیت اپلیکیشن هوش مصنوعی باید چندلایه باشد.
نباید انتظار داشت یک کنترل بهتنهایی همه حملات را مسدود کند.
لایه اول؛ Authentication
سیستم باید بداند چه کسی درخواست را ارسال کرده است.
Session، Token و API Key باید مانند سایر اپلیکیشنهای وب بهشکل امن مدیریت شوند.
لایه دوم؛ Authorization
پس از شناسایی کاربر باید مشخص شود به چه Resourceهایی اجازه دسترسی دارد.
Authorization بهتر است قبل از Retrieval و قبل از اجرای Tool اعمال شود.
لایه سوم؛ Input Controls
ورودی کاربر باید براساس کاربرد سیستم محدود شود.
برای مثال:
- محدودیت طول
- محدودیت نوع فایل
- MIME Validation
- Upload Scanning
- Schema Validation
- Content Classification
لایه چهارم؛ Context Isolation
دادههای مربوط به کاربران یا Tenantهای مختلف نباید بدون کنترل وارد Context مشترک شوند.
لایه پنجم؛ Model Controls
System Prompt، Guardrail و Safety Filter مفید هستند، اما باید مکمل کنترلهای Backend باشند.
لایه ششم؛ Tool Security
هر Tool باید با حداقل Permission و Validation مستقل کار کند.
لایه هفتم؛ Output Validation
خروجی LLM براساس Destination Context بررسی شود.
لایه هشتم؛ Monitoring
رفتار مدل و Toolها باید قابل مشاهده و Audit باشد.
معماری امن Toolها
یکی از بهترین روشها این است که Toolها بسیار محدود و هدفمند باشند.
بهجای Tool عمومی مانند:
execute_database_command
بهتر است قابلیتها به عملیات محدود و مشخص تقسیم شوند.
برای مثال در سطح مفهومی:
get_order_status
امنتر از دسترسی عمومی به دیتابیس است.
Tool کوچکتر باعث میشود:
- ورودی سادهتر Validation شود،
- Authorization دقیقتر باشد،
- Log قابل فهمتر شود،
- Blast Radius کاهش یابد.
Structured Output؛ خروجی ساختاریافته بهجای متن آزاد
در بسیاری از Workflowها لازم نیست مدل متن آزاد تولید کند.
میتوان انتظار داشت مدل Schema مشخصی برگرداند.
برای مثال خروجی باید دارای:
- action
- resource_id
- reason
باشد.
Backend سپس Schema را Validation میکند.
البته Structured Output بهتنهایی امنیت ایجاد نمیکند.
اگر مدل بنویسد action برابر delete است، Backend همچنان باید بررسی کند آیا این Action مجاز است یا خیر.
اما Schema سطح ابهام را کاهش میدهد.
امنیت Browser در اپلیکیشنهای LLM
Frontend نیز بخش مهمی از امنیت Web LLM Attacks است.
اگر پاسخ مدل مستقیماً Render شود، باید نوع محتوا مشخص باشد.
برای Chat UI معمولاً بهتر است:
- HTML خام مدل اجرا نشود،
- JavaScript تولیدشده اجرا نشود،
- لینکها با سیاست مناسب مدیریت شوند،
- Markdown Sanitized شود،
- CSP مناسب وجود داشته باشد.
هرچه مدل قابلیت تولید Rich Content بیشتری داشته باشد، اهمیت Output Encoding افزایش پیدا میکند.
SSRF در سامانههای AI
برخی Agentها اجازه دریافت URL یا خواندن منابع وب دارند.
این قابلیت میتواند سطح SSRF را افزایش دهد.
Backend نباید اجازه دهد مدل آزادانه هر مقصد شبکهای را درخواست کند.
بهتر است Egress Policy مشخصی وجود داشته باشد.
برای مثال:
- Destination Allowlist
- مسدود کردن Private IP Rangeها
- جلوگیری از دسترسی به Metadata Service
- DNS Validation
- Redirect Control
- Timeout و Size Limit
اعمال شود.
این کنترلها باید در Network و Backend اعمال شوند، نه در Prompt.
مدیریت Secret در اپلیکیشنهای LLM
API Key یا Token نباید در:
- Prompt
- Client-Side JavaScript
- Repository عمومی
- Log
- Conversation History
قرار گیرد.
Secretها باید از Secret Manager یا مکانیزم امن مشابه دریافت شوند.
همچنین بهتر است Credential هر Integration Scope حداقلی داشته باشد.
در صورت افشای یک Token محدود، میزان خسارت بسیار کمتر از Credential کامل خواهد بود.
امنیت RAG بهصورت عملی
یک RAG امن باید حداقل چند کنترل اصلی داشته باشد.
کنترل Source
فقط منابع مجاز وارد Knowledge Base شوند.
کنترل هویت
Document باید مشخص کند متعلق به کدام User، Team یا Tenant است.
کنترل Retrieval
Filter دسترسی باید در Query اعمال شود.
کنترل Metadata
اطلاعاتی مانند:
- Owner
- Tenant
- Classification
- Source
- Created Date
- Version
میتواند برای تصمیمگیری امنیتی استفاده شود.
کنترل Ingestion
فایل قبل از ورود به Pipeline بررسی شود.
کنترل Context
تعداد و نوع Chunkهایی که وارد Prompt میشوند محدود باشد.
کنترل خروجی
مدل نباید صرفاً به دلیل بازیابی یک سند، تمام محتوای آن را در اختیار کاربر قرار دهد.
حافظه LLM و خطر نشت بین کاربران
برخی سیستمها دارای Memory هستند.
Memory ممکن است ترجیحات کاربر یا اطلاعات قبلی را نگهداری کند.
اگر Memory Isolation ضعیف باشد، داده یک کاربر میتواند وارد Session کاربر دیگر شود.
به همین دلیل Memory نیز مانند Database باید:
- User Bound باشد،
- Access Control داشته باشد،
- قابلیت حذف داشته باشد،
- Retention Policy داشته باشد.
همچنین نباید هر اطلاعاتی بهصورت خودکار وارد Memory شود.
Logging؛ بین قابلیت تشخیص و خطر افشای اطلاعات
Logging برای تشخیص حملات ضروری است.
اما ذخیره تمام Promptها و Responseها بدون کنترل نیز میتواند خطر ایجاد کند.
Log ممکن است شامل:
- اطلاعات شخصی
- Token
- فایل خصوصی
- داده تجاری
- Prompt داخلی
باشد.
بنابراین باید Data Minimization انجام شود.
بهتر است اطلاعات حساس Mask یا Redact شوند.
دسترسی به Log نیز باید محدود باشد.
چه چیزهایی برای امنیت ثبت شوند؟
بسته به سیستم میتوان موارد زیر را ثبت کرد:
- User ID
- Session ID
- Model
- Tool Call
- Tool Result Status
- Request Size
- Token Usage
- Latency
- Security Decision
- Authorization Failure
- Rate Limit Event
هدف این است که بتوان رفتار مشکوک را بررسی کرد، بدون اینکه Logging خود به دیتابیس اطلاعات محرمانه تبدیل شود.
نقش WAF در مقابله با Web LLM Attacks
WAF همچنان ارزشمند است.
میتواند بسیاری از تهدیدهای کلاسیک HTTP را شناسایی یا محدود کند.
اما WAF بهتنهایی برای امنیت LLM کافی نیست.
Prompt Injection یک مسئله معنایی است.
یک ورودی ممکن است از نظر:
- HTTP
- Syntax
- Encoding
کاملاً معتبر باشد اما معنی آن رفتار مدل را تغییر دهد.
بنابراین WAF یکی از لایههای امنیت است، نه راهکار جامع Web LLM Attacks.
آیا Input Sanitization میتواند Prompt Injection را متوقف کند؟
Sanitization مفید است ولی تضمین مطلق ایجاد نمیکند.
برای دادههای ساختاریافته میتوان Validation دقیقی داشت.
اما زبان طبیعی دامنه بسیار بزرگی دارد.
به همین دلیل معماری باید فرض کند برخی ورودیهای مخرب از فیلتر عبور خواهند کرد.
پس سؤال دوم همیشه باید این باشد:
«اگر ورودی مخرب عبور کرد، چه چیزی مانع ایجاد خسارت میشود؟»
پاسخ باید شامل Permission Control، Tool Restrictions، Output Validation و Isolation باشد.
طراحی Threat Model برای اپلیکیشن متصل به هوش مصنوعی
قبل از انتشار یک قابلیت AI بهتر است Threat Model تهیه شود.
مرحله اول؛ Assetها را مشخص کنید
چه چیزی ارزش محافظت دارد؟
برای مثال:
- حساب کاربران
- اسناد
- اطلاعات مالی
- Credential
- API
- مدل اختصاصی
- داده آموزشی
مرحله دوم؛ Data Flow را رسم کنید
ورودی از کجا میآید و به کجا میرود؟
مرحله سوم؛ Trust Boundaryها را مشخص کنید
مرز میان:
- User و Backend
- Backend و LLM Provider
- LLM و Tool
- RAG و Vector DB
- Application و Third Party
باید روشن باشد.
مرحله چهارم؛ Privilegeها را بررسی کنید
مدل به چه قابلیتهایی دسترسی دارد؟
مرحله پنجم؛ Failure Scenario بسازید
فرض کنید مدل:
- دستور اشتباه فهمید،
- داده اشتباه بازیابی کرد،
- Prompt Injection پذیرفت،
- Tool اشتباه انتخاب کرد.
آیا سیستم همچنان امن باقی میماند؟
اگر پاسخ منفی است، معماری بیش از حد به رفتار مدل اعتماد دارد.
تست امنیت Web LLM Applications
تست امنیت این سیستمها باید هم امنیت کلاسیک وب و هم رفتار AI را پوشش دهد.
تست Authentication و Authorization
باید بررسی شود آیا User میتواند از طریق LLM به Resourceهایی دسترسی پیدا کند که از رابط معمول سایت مجاز نیست.
تست Prompt Injection
هدف تست باید مشخص کردن این باشد که آیا محتوای غیرقابل اعتماد میتواند رفتار سیستم را تغییر دهد.
تست دفاعی نباید فقط یک Prompt شناختهشده داشته باشد.
سناریوهای مختلف باید بررسی شوند.
تست Indirect Injection
اسناد و منابع خارجی نیز باید در محیط آزمایشی بررسی شوند.
تست Tool Authorization
حتی اگر مدل Tool غیرمجاز درخواست کند، Backend باید آن را رد کند.
تست Data Isolation
در سیستم Multi-Tenant باید بررسی شود داده Tenantها کاملاً جدا باقی میماند.
تست Output Handling
خروجی مدل در تمام Contextهای مصرفکننده بررسی شود.
تست Cost Abuse
Rate Limit، Token Limit و Agent Loop باید آزمایش شوند.
چرا Security Testing سنتی بهتنهایی کافی نیست؟
اسکنرهای DAST و SAST همچنان ارزش زیادی دارند.
آنها میتوانند ضعفهای کلاسیک کد و Web Application را پیدا کنند.
اما رفتار LLM همیشه از Static Code Analysis قابل استنتاج نیست.
برای همین بهتر است تستها ترکیبی از موارد زیر باشند:
- SAST
- DAST
- Dependency Scanning
- API Security Testing
- LLM Red Teaming
- Abuse Case Testing
- RAG Security Testing
- Authorization Testing
OWASP نیز بر استفاده از کنترلهای Secure Coding، تست امنیت و بررسی ورودی و خروجی در کنار کنترلهای اختصاصی LLM تأکید میکند.
نمونه کاربرد در سایتهای وردپرسی
وردپرس نیز بهسرعت در حال استفاده بیشتر از قابلیتهای AI است.
یک سایت WordPress ممکن است از هوش مصنوعی برای:
- Chatbot
- تولید محتوا
- پشتیبانی
- جستجوی هوشمند
- WooCommerce
- خلاصهسازی
- پاسخ به مشتری
- مدیریت محتوا
استفاده کند.
خطر زمانی افزایش مییابد که Plugin هوش مصنوعی به Permissionهای مدیریتی WordPress دسترسی داشته باشد.
برای مثال افزونهای که فقط برای تولید متن نصب شده، نباید بدون ضرورت بتواند:
- User ایجاد کند،
- تنظیمات تغییر دهد،
- Plugin نصب کند،
- Post حذف کند،
- Order تغییر دهد.
Permission افزونه و Credential مورد استفاده API باید بررسی شوند.
امنیت AI در WooCommerce
در فروشگاه اینترنتی اطلاعات حساستری وجود دارد.
یک Assistant ممکن است برای پاسخ به سؤال مشتری به:
- سفارش
- آدرس
- ایمیل
- وضعیت پرداخت
- محصولات
دسترسی داشته باشد.
اگر Access Control فقط بر عهده LLM گذاشته شود، خطر Data Leakage ایجاد میشود.
Backend باید مطمئن شود User فقط Orderهای متعلق به خودش را مشاهده میکند.
LLM نباید Order ID ارائهشده توسط User را بهتنهایی نشانه مجاز بودن دسترسی بداند.
این همان اصل Broken Access Control است که در محیط AI نیز باید رعایت شود.
Incident Response برای Web LLM Attacks
حتی با معماری مناسب باید احتمال Incident در نظر گرفته شود.
برای پاسخ مناسب بهتر است از قبل مشخص باشد:
- Logها کجا هستند؟
- چه Toolهایی اجرا شدهاند؟
- کدام User درخواست را ایجاد کرده؟
- چه سندی وارد Context شده؟
- چه Credentialهایی درگیر بودهاند؟
- آیا Token باید Rotate شود؟
- آیا Vector Store باید Rebuild شود؟
- آیا Knowledge Base آلوده شده است؟
Kill Switch
برای Agentهای قدرتمند داشتن مکانیزم سریع غیرفعال کردن Toolها مفید است.
در شرایط Incident ممکن است لازم باشد بدون خاموش کردن کل سرویس AI، فقط قابلیتهای حساس متوقف شوند.
چکلیست امنیت سایتهای متصل به LLM
قبل از انتشار سیستم میتوان این چکلیست را بررسی کرد:
- آیا Authentication مستقل از LLM است؟
- آیا Authorization در Backend انجام میشود؟
- آیا System Prompt فاقد Secret است؟
- آیا مدل حداقل Permission لازم را دارد؟
- آیا Toolها محدود و تخصصی هستند؟
- آیا Tool Input اعتبارسنجی میشود؟
- آیا Tool Output نیز غیرقابل اعتماد تلقی میشود؟
- آیا RAG براساس User یا Tenant فیلتر میشود؟
- آیا اسناد Knowledge Base منبع مشخص دارند؟
- آیا فایلهای ورودی بررسی میشوند؟
- آیا خروجی مدل قبل از HTML Rendering Sanitized میشود؟
- آیا Query تولیدشده توسط مدل مستقیماً اجرا نمیشود؟
- آیا دسترسی شبکه Agent محدود است؟
- آیا Rate Limit وجود دارد؟
- آیا Token Budget تعریف شده است؟
- آیا Agent Step Limit وجود دارد؟
- آیا عملیات حساس نیازمند تأیید هستند؟
- آیا Logging کافی وجود دارد؟
- آیا دادههای حساس در Log ماسک میشوند؟
- آیا Alert برای رفتار غیرعادی وجود دارد؟
- آیا تست Indirect Prompt Injection انجام شده است؟
- آیا تست Cross-Tenant Data Leakage انجام شده است؟
- آیا Dependencyها و Pluginها بررسی شدهاند؟
- آیا Secret Rotation Plan وجود دارد؟
- آیا Incident Response برای AI تعریف شده است؟
اشتباهات رایج در امنیت Web LLM
اشتباه اول؛ اعتماد کامل به System Prompt
System Prompt سیاست رفتاری مدل است، نه Firewall.
کنترلهای حیاتی باید در Backend اعمال شوند.
اشتباه دوم؛ قرار دادن Secret داخل Prompt
هیچ Credential مهمی نباید برای «راحتی مدل» داخل Prompt قرار گیرد.
اشتباه سوم؛ دادن Permission کامل به Agent
Agent باید دقیقاً همان دسترسی لازم را داشته باشد و نه بیشتر.
اشتباه چهارم؛ اعتماد به خروجی مدل
Output مدل باید Untrusted Input در نظر گرفته شود.
اشتباه پنجم؛ استفاده از یک Vector Store بدون Isolation مناسب
Similarity Search جایگزین Authorization نیست.
اشتباه ششم؛ فرض اینکه RAG مشکل Prompt Injection را حل میکند
RAG حتی میتواند مسیر Indirect Prompt Injection ایجاد کند.
اشتباه هفتم؛ تمرکز فقط بر Jailbreak
Jailbreak تنها بخشی از امنیت LLM است.
ریسک واقعی ممکن است در API، RAG، Tool، Permission یا Output Handling باشد.
اشتباه هشتم؛ تکیه کامل بر WAF
WAF برای Web Security مهم است اما رفتار معنایی مدل را بهتنهایی کنترل نمیکند.
اشتباه نهم؛ Logging تمام اطلاعات
ثبت بیهدف Prompt و Response ممکن است خودش Data Leakage ایجاد کند.
اشتباه دهم؛ انجام عملیات حساس بدون تأیید
هرچه Impact عملیات بیشتر باشد، نیاز به کنترل مستقل بیشتر میشود.
تفاوت Jailbreak و Prompt Injection چیست؟
این دو اصطلاح گاهی بهجای یکدیگر استفاده میشوند، اما کاملاً یکسان نیستند.
Jailbreak معمولاً به تلاش برای دور زدن محدودیتهای رفتاری یا Safety Policy مدل اشاره دارد.
Prompt Injection مفهوم گستردهتری دارد و میتواند هدفش تغییر نحوه اجرای وظیفه در یک Application باشد.
در امنیت Web LLM، Prompt Injection خطرناکتر زمانی است که بتواند به:
- Data
- Tool
- API
- Action
متصل شود.
اصل مهم؛ LLM را مانند کاربر غیرقابل اعتماد در نظر بگیرید
یکی از مفیدترین مدلهای ذهنی در طراحی امنیت این است:
LLM را یک موجود قابل اعتماد داخل شبکه تصور نکنید.
مدل ممکن است:
- اشتباه کند،
- Hallucination داشته باشد،
- تحت تأثیر Prompt قرار گیرد،
- Tool اشتباه انتخاب کند،
- خروجی ناامن تولید کند.
بنابراین درخواست مدل برای اجرای یک عملیات باید تقریباً مانند درخواست یک Client خارجی بررسی شود.
این نگاه بسیاری از اشتباهات معماری را از ابتدا حذف میکند.
آینده Web LLM Attacks با گسترش Agentic AI
با حرکت سیستمها از Chatbot ساده به Agentهای چندمرحلهای، امنیت پیچیدهتر میشود.
یک Agent ممکن است:
- هدف را تحلیل کند.
- برنامه ایجاد کند.
- Tool انتخاب کند.
- نتیجه Tool را بررسی کند.
- Tool دیگری اجرا کند.
- تصمیم جدید بگیرد.
در چنین معماریای، یک خطای کوچک میتواند در چند مرحله تکثیر شود.
به همین دلیل مفهوم Blast Radius بسیار مهم میشود.
حتی اگر Agent تصمیم اشتباه گرفت، باید محدوده تأثیر آن کوچک باشد.
Least Privilege، Segmentation، Human Approval و Monitoring پایههای اصلی این رویکرد هستند.
سؤالات متداول درباره Web LLM Attacks
Web LLM Attacks چیست؟
Web LLM Attacks مجموعه حملاتی هستند که اپلیکیشنهای وب مجهز به مدلهای زبانی بزرگ را هدف قرار میدهند. این حملات میتوانند Prompt، RAG، Toolها، APIها، Vector Database، System Prompt یا خروجی مدل را تحت تأثیر قرار دهند.
آیا Prompt Injection همان SQL Injection است؟
خیر. هر دو از مشکل مرزبندی میان داده و دستور الهام میگیرند، اما مکانیسم آنها متفاوت است. SQL Injection یک مسئله مربوط به Interpreter و Query است، در حالی که Prompt Injection رفتار یک مدل زبانی را از طریق Context تحت تأثیر قرار میدهد.
آیا میتوان Prompt Injection را کاملاً مسدود کرد؟
فیلتر ورودی و Guardrail میتواند ریسک را کاهش دهد، اما معماری امن نباید فرض کند هیچ Prompt Injectionی عبور نخواهد کرد. Permission محدود، Authorization مستقل و کنترل Toolها اهمیت بیشتری دارند.
آیا مخفی کردن System Prompt امنیت سیستم را بالا میبرد؟
افشای نکردن جزئیات داخلی مفید است، اما System Prompt نباید Security Boundary باشد. Secret و Permission واقعی باید خارج از Prompt مدیریت شوند.
آیا استفاده از RAG امنیت LLM را افزایش میدهد؟
RAG میتواند پاسخها را مرتبطتر کند اما خود دارای ریسکهایی مانند Poisoning، Data Leakage و ضعف Vector Access Control است. RAG جایگزین کنترل امنیتی نیست.
Vector Database چه خطر امنیتی دارد؟
اگر Metadata Filtering و Access Control ضعیف باشد، ممکن است اطلاعات یک User یا Tenant برای دیگری بازیابی شود. همچنین Knowledge Base میتواند هدف Data Poisoning قرار گیرد.
آیا خروجی ChatGPT یا سایر LLMها امن محسوب میشود؟
خیر. در معماری نرمافزار باید خروجی LLM را داده غیرقابل اعتماد در نظر گرفت و براساس محل مصرف Validation، Sanitization یا Encoding مناسب انجام داد.
چرا Excessive Agency خطرناک است؟
هرچه Agent Tool و Permission بیشتری داشته باشد، یک خطا یا Prompt Injection میتواند اثر بیشتری ایجاد کند. به همین دلیل Agent باید با Least Privilege طراحی شود.
آیا WAF میتواند جلوی Web LLM Attacks را بگیرد؟
WAF میتواند بخشی از حملات سنتی وب و برخی الگوهای شناختهشده را شناسایی کند، اما برای Prompt Injection و مسائل معنایی LLM کافی نیست.
بهترین روش محافظت از سایت متصل به هوش مصنوعی چیست؟
یک کنترل واحد کافی نیست. Authentication و Authorization مستقل، Least Privilege، RAG Isolation، Input Validation، Output Sanitization، محدودسازی Tool، Rate Limiting، Monitoring و Human Approval برای عملیات حساس باید در کنار یکدیگر استفاده شوند.
جمعبندی
Web LLM Attacks نشان میدهد اضافه کردن هوش مصنوعی به یک سایت صرفاً اضافه کردن یک API جدید نیست؛ بلکه میتواند مدل اعتماد و سطح حمله کل سامانه را تغییر دهد.
Prompt Injection یکی از شناختهشدهترین تهدیدهاست، اما امنیت LLM بسیار فراتر از آن است. Sensitive Information Disclosure، Improper Output Handling، Excessive Agency، ضعف RAG و Vector Database، Data Poisoning، Supply Chain، هزینههای کنترلنشده و ضعف جداسازی کاربران همگی میتوانند امنیت اپلیکیشن را تحت تأثیر قرار دهند.
اصل بنیادین این است که مدل زبانی نباید نقش یک Security Boundary را بازی کند.
Authorization باید در Backend انجام شود. Credential نباید داخل Prompt باشد. Toolها باید حداقل دسترسی را داشته باشند. داده RAG باید بر مبنای User و Tenant جدا شود. خروجی مدل باید Untrusted در نظر گرفته شود و عملیات حساس نیز بهتر است کنترل مستقل یا Human-in-the-Loop داشته باشند.
یک معماری قوی باید حتی در شرایطی که LLM اشتباه میکند، Prompt Injection را میپذیرد یا Tool نادرستی را پیشنهاد میدهد، همچنان از Assetهای حیاتی محافظت کند.
در نهایت، مهمترین راه مقابله با Web LLM Attacks تلاش برای ساخت یک مدل «کاملاً فرمانبردار و غیرقابل فریب» نیست؛ بلکه ساخت سیستمی است که شکست یا فریب مدل نتواند مستقیماً به شکست امنیت کل اپلیکیشن تبدیل شود.
مطالب مرتبط