Incident Response چیست؟ چگونه برای حمله و رخداد امنیتی سایت آماده شویم؟
Incident Response یا پاسخ به رخداد امنیتی، فرایندی ساختاریافته برای شناسایی، تحلیل، مهار و بازیابی سیستمها پس از حملات سایبری است. داشتن برنامه پاسخ به رخداد به مدیران سایت کمک میکند خسارت ناشی از نفوذ، آلودگی بدافزاری، سرقت اطلاعات و اختلال خدمات را کاهش دهند. مهمترین اقدامات شامل پایش امنیتی، مدیریت دسترسیها، حفظ شواهد، تهیه نسخه پشتیبان سالم و رفع علت اصلی حادثه هستند.
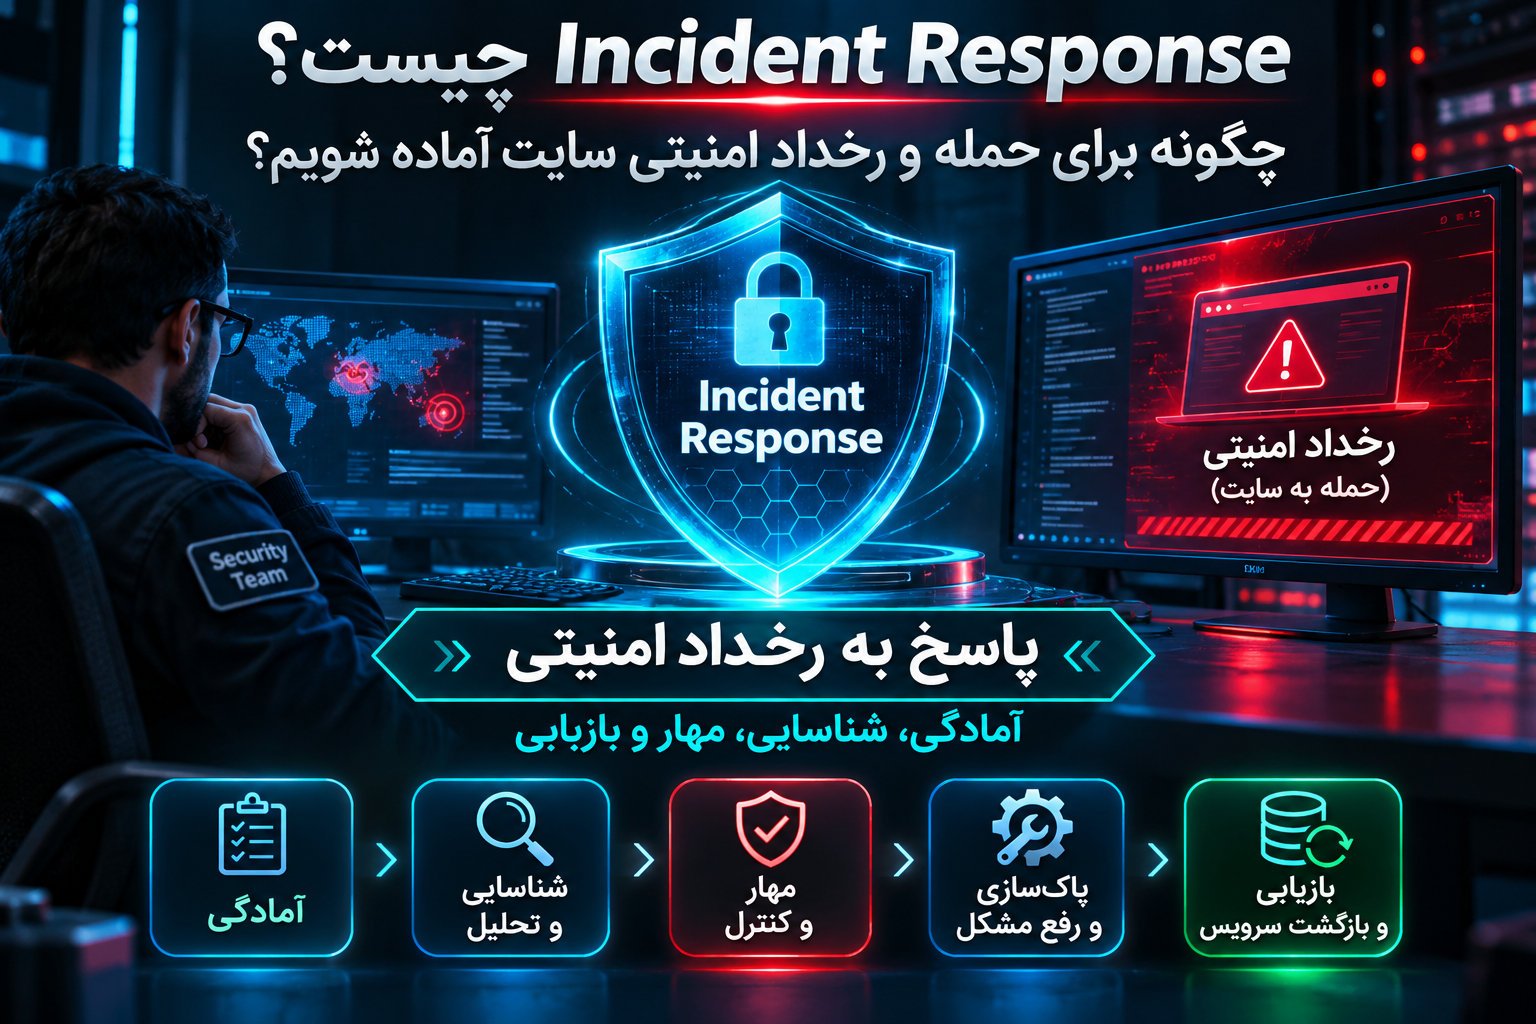
Incident Response یا پاسخ به رخداد امنیتی مجموعهای از اقدامات برنامهریزیشده برای شناسایی، تحلیل، مهار، پاکسازی و بازیابی سیستمها پس از وقوع یک حادثه امنیتی است. برای آمادهسازی سایت در برابر حملات سایبری، باید برنامه پاسخ به رخداد داشته باشید، فعالیتهای مشکوک را پایش کنید، نسخه پشتیبان سالم نگه دارید، مسئولیت افراد را مشخص کنید و روش بازگرداندن امن سایت را پیش از وقوع حمله آزمایش کرده باشید.
مقدمه: چرا هر وبسایتی به برنامه پاسخ به رخداد امنیتی نیاز دارد؟
تصور کنید یک روز وارد پنل مدیریت سایت خود میشوید و متوجه میشوید اطلاعات برخی صفحات تغییر کرده، کاربران ناشناسی به سیستم اضافه شدهاند یا سایت به آدرسهای مشکوک هدایت میشود. شاید هم شرکت هاستینگ به شما اطلاع دهد که فایلهای مخربی روی سرور شناسایی شدهاند و برای جلوگیری از گسترش آلودگی، دسترسی به سایت موقتاً محدود شده است.
در چنین شرایطی چه کاری باید انجام دهید؟ آیا باید فوراً تمام فایلهای مشکوک را حذف کنید؟ آیا بازگردانی آخرین نسخه پشتیبان کافی است؟ چگونه میتوان تشخیص داد که اطلاعات مشتریان افشا شده یا مهاجم هنوز به سرور دسترسی دارد؟
پاسخ صحیح به این پرسشها به داشتن یک برنامه Incident Response وابسته است.
بسیاری از مدیران سایتها تمام تمرکز خود را روی جلوگیری از حملات قرار میدهند. نصب افزونه امنیتی، فعالسازی فایروال، استفاده از رمز عبور قوی و بهروزرسانی نرمافزارها اقدامات ارزشمندی هستند؛ اما هیچکدام امنیت مطلق ایجاد نمیکنند.
حتی سایتی که از تنظیمات امنیتی مناسبی برخوردار است، ممکن است بهدلیل آسیبپذیری ناشناخته، سرقت اطلاعات ورود، اشتباه انسانی یا مشکل امنیتی در یکی از سرویسدهندگان دچار حادثه شود.
تفاوت میان یک رخداد قابلکنترل و بحرانی که چندین روز فعالیت کسبوکار را مختل میکند، معمولاً در میزان آمادگی و کیفیت تصمیمگیری هنگام حادثه است.
پاسخ به رخداد امنیتی کمک میکند بهجای انجام اقدامات پراکنده، براساس یک فرایند مشخص تصمیم بگیرید؛ فرایندی که حفاظت از اطلاعات، کاهش خسارت، حفظ شواهد و بازیابی خدمات را همزمان در نظر میگیرد.
در این راهنمای جامع از رخنهکاو، مفهوم Incident Response، مراحل اجرای آن، نحوه آمادگی سایتهای وردپرسی، مدیریت رخدادهای امنیتی فروشگاههای اینترنتی و روش تدوین برنامه عملیاتی پاسخ به حادثه را بررسی میکنیم.
Incident Response چیست؟
Incident Response که به فارسی «پاسخ به رخداد امنیتی» نامیده میشود، فرایندی سازمانیافته برای مدیریت حوادثی است که محرمانگی، یکپارچگی یا دسترسپذیری اطلاعات و سیستمها را تهدید میکنند.
هدف این فرایند صرفاً برطرفکردن آثار ظاهری حمله نیست؛ بلکه باید مشخص شود چه اتفاقی افتاده، کدام منابع تحتتأثیر قرار گرفتهاند، مهاجم چگونه وارد شده و چه اقداماتی برای جلوگیری از تکرار حادثه ضروری است.
برای مثال، اگر یک وبسایت وردپرسی آلوده شود، پاککردن فایل مخرب ممکن است نشانه آشکار آلودگی را برطرف کند؛ اما اگر حساب مدیریتی مهاجم همچنان فعال باشد، امکان آلودگی مجدد وجود دارد.
یک فرایند استاندارد پاسخ به رخداد، علاوه بر حذف فایل آلوده، وضعیت حسابهای کاربری، نشستهای فعال، افزونهها، تنظیمات سرور، گزارشهای امنیتی و سایر مسیرهای احتمالی دسترسی را نیز بررسی میکند.
سه هدف اصلی Incident Response عبارتاند از:
- کاهش خسارت: جلوگیری از گسترش حمله، محدودکردن دسترسی غیرمجاز و محافظت از اطلاعات و سرویسهای حیاتی.
- بازگرداندن عملکرد امن: رفع علت حادثه و بازیابی خدمات با اطمینان قابلقبول از سالمبودن محیط.
- جلوگیری از تکرار: شناسایی نقاط ضعف و اصلاح فرایندها، تنظیمات و کنترلهای امنیتی.
پاسخ به رخداد میتواند در یک وبسایت کوچک توسط مدیر سایت و شرکت هاستینگ انجام شود یا در یک سازمان بزرگ به تیمی تخصصی شامل کارشناسان امنیت، مدیران زیرساخت و مسئولان حقوقی نیاز داشته باشد.
نکته مهم این است که Incident Response یک اقدام مقطعی نیست؛ بلکه قابلیتی دائمی است که پیش از رخداد ایجاد میشود، هنگام حادثه به کار میآید و پس از آن بهبود پیدا میکند.
تفاوت رویداد امنیتی، رخداد امنیتی و نفوذ موفق
برای مدیریت درست حوادث سایبری، ابتدا باید تفاوت چند اصطلاح مهم را بدانیم.
رویداد امنیتی (Security Event)
رویداد امنیتی اتفاقی است که در سیستم ثبت میشود و ممکن است به امنیت ارتباط داشته باشد؛ اما لزوماً نشاندهنده حمله موفق نیست.
برای مثال، چند تلاش ناموفق برای ورود به حساب مدیریت میتواند یک رویداد امنیتی باشد. این فعالیت ممکن است ناشی از اشتباه کاربر یا تلاش خودکار برای حدس رمز عبور باشد.
رخداد امنیتی (Security Incident)
رخداد امنیتی زمانی مطرح میشود که یک یا چند رویداد نشاندهنده نقض واقعی یا احتمالی سیاستهای امنیتی، دسترسی غیرمجاز یا تهدید جدی برای داراییهای سازمان باشند.
برای نمونه، ورود موفق با اطلاعات کاربری سرقتشده و تغییر غیرمجاز تنظیمات سایت، یک رخداد امنیتی محسوب میشود.
نفوذ یا نقض امنیتی (Security Breach)
نقض امنیتی معمولاً به وضعیتی اشاره دارد که یک مرز امنیتی شکسته شده یا دسترسی غیرمجاز به سیستم یا اطلاعات رخ داده است.
اگر مشخص شود مهاجم توانسته فایلهای حساس سایت را مشاهده کند یا اطلاعات مشتریان را استخراج کند، احتمال وقوع یک نقض امنیتی وجود دارد.
البته هر رخداد امنیتی الزاماً به افشای داده منجر نمیشود و هر هشدار امنیتی نیز اثباتکننده نفوذ موفق نیست.
| مفهوم | تعریف | نمونه در وبسایت |
|---|---|---|
| Security Event | فعالیت ثبتشده با اهمیت احتمالی امنیتی | چند ورود ناموفق |
| Security Alert | هشدار تولیدشده توسط سامانه نظارتی | هشدار تغییر فایل حساس |
| Security Incident | حادثه واقعی یا مشکوک نیازمند رسیدگی امنیتی | ایجاد حساب مدیر بدون مجوز |
| Security Breach | نقض مرز امنیتی یا دسترسی غیرمجاز | دسترسی مهاجم به داده محرمانه |
تشخیص صحیح این مفاهیم از ایجاد هشدارهای بیمورد جلوگیری میکند و به تیم امنیت اجازه میدهد منابع خود را روی خطرات واقعی متمرکز کند.
چرا Incident Response برای امنیت سایت اهمیت دارد؟
یک حمله سایبری ممکن است ظرف مدت کوتاهی از یک مشکل فنی محدود به بحرانی عملیاتی تبدیل شود.
برای مثال، دسترسی غیرمجاز به حساب مدیر سایت میتواند به تغییر صفحات، ایجاد حسابهای جدید، دستکاری تنظیمات و حتی دسترسی به اطلاعات کاربران منجر شود.
اگر این فعالیت زود شناسایی شود، ممکن است بتوان خسارت را محدود کرد؛ اما تأخیر در تشخیص و مهار حادثه، دامنه آسیب را افزایش میدهد.
جلوگیری از گسترش حمله
یکی از مهمترین اهداف پاسخ به رخداد، جلوگیری از حرکت مهاجم به بخشهای دیگر زیرساخت است.
در محیطهایی که چند وبسایت روی یک سرور میزبانی میشوند، ضعف در جداسازی حسابها یا مجوزهای دسترسی میتواند دامنه یک حادثه را گسترش دهد.
اقداماتی مانند محدودکردن دسترسی حساب آسیبدیده، جداسازی محیط مشکوک و مسدودکردن مسیرهای ارتباطی خطرناک به مهار حادثه کمک میکنند.
کاهش زمان قطعی سایت
هر ساعت اختلال در یک وبسایت تجاری میتواند به کاهش فروش، افزایش درخواستهای پشتیبانی و نارضایتی کاربران منجر شود.
برنامه پاسخ به رخداد باعث میشود تیم فنی در زمان بحران مجبور نباشد تمام مراحل بازیابی را از ابتدا طراحی کند.
محافظت از دادههای کاربران
اطلاعات کاربران، سفارشها، مشخصات تماس و دادههای تجاری از مهمترین داراییهای یک وبسایت هستند.
در رخدادهای مرتبط با اطلاعات شخصی، علاوه بر رفع مشکل فنی، بررسی دامنه افشا و مسئولیتهای اطلاعرسانی نیز اهمیت پیدا میکند.
حفاظت از اعتبار و اعتماد کاربران
آسیب امنیتی ممکن است با تغییر ظاهر سایت، نمایش محتوای مخرب، ارسال پیامهای ناخواسته یا هشدار مرورگرها همراه باشد.
مدیریت شفاف و مسئولانه حادثه، همراه با رفع واقعی مشکل، میتواند به حفظ اعتماد کاربران کمک کند.
جلوگیری از تصمیمهای اشتباه
در شرایط اضطراری، حذف شتابزده فایلها، نصب ابزارهای نامطمئن یا بازگردانی نسخه پشتیبان آلوده ممکن است وضعیت را پیچیدهتر کند.
وجود برنامه مشخص، مسئولیت تصمیمگیری و ترتیب اقدامات را روشن میکند. 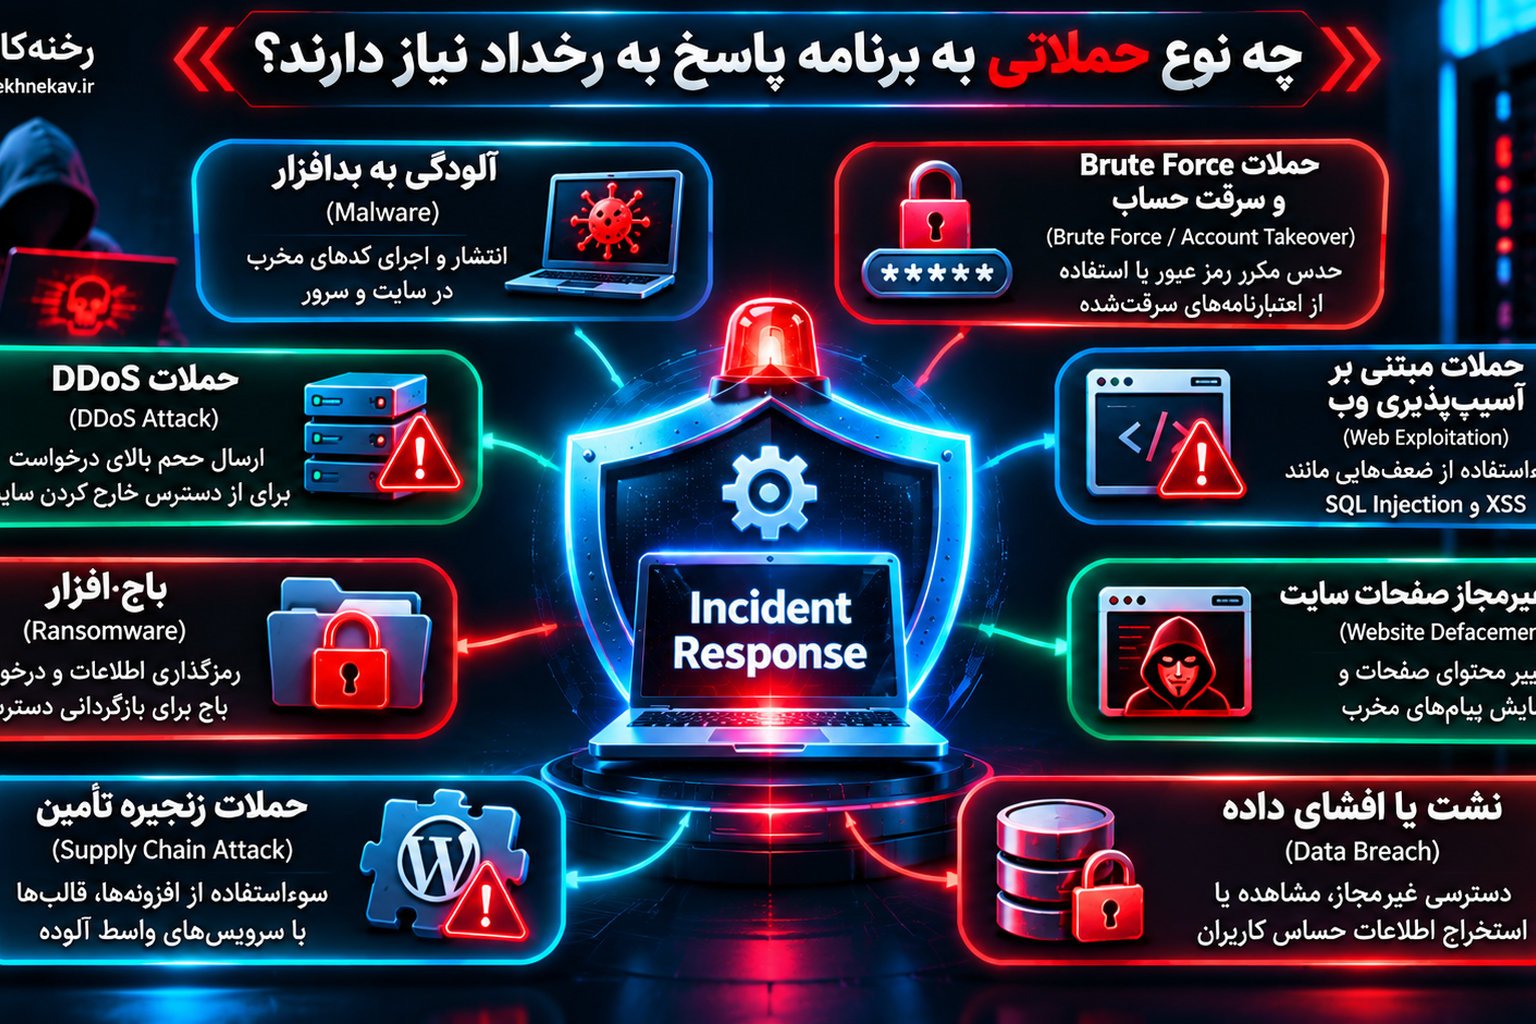
چه نوع حملاتی به برنامه پاسخ به رخداد نیاز دارند؟
Incident Response برای طیف گستردهای از تهدیدات کاربرد دارد. نوع حمله بر روش شناسایی، مهار و بازیابی تأثیر میگذارد.
آلودگی سایت به بدافزار (Malware)
بدافزار ممکن است فایلهای سایت را تغییر دهد، محتوای ناخواسته ایجاد کند، بازدیدکنندگان را هدایت کند یا ارتباطات غیرمجاز برقرار سازد.
در چنین وضعیتی باید دامنه آلودگی مشخص شود و احتمال وجود روشهای دسترسی پنهان نیز بررسی گردد.
حملات Brute Force و سرقت حساب کاربری
در حملات Brute Force مهاجم تلاش میکند با حدسزدن مکرر اطلاعات ورود، به حساب کاربری دسترسی پیدا کند.
اما همه موارد تصاحب حساب از طریق حدس رمز عبور رخ نمیدهند. فیشینگ، استفاده مجدد از رمزهای افشاشده و سرقت نشستهای کاربری نیز میتوانند به دسترسی غیرمجاز منجر شوند.
حملات DDoS
در حمله Distributed Denial of Service حجم زیادی از درخواستها یا ترافیک به زیرساخت هدف ارسال میشود تا دسترسی کاربران واقعی مختل شود.
پاسخ مناسب ممکن است شامل همکاری با ارائهدهنده CDN، تنظیم کنترلهای نرخ درخواست و استفاده از سرویسهای مقابله با DDoS باشد.
حملات مبتنی بر آسیبپذیری وب
آسیبپذیریهایی مانند SQL Injection، Cross-Site Scripting یا XSS و برخی نقصهای کنترل دسترسی میتوانند پیامدهای امنیتی جدی ایجاد کنند.
وجود یک آسیبپذیری بهتنهایی به معنای نفوذ موفق نیست؛ اما شناسایی شواهد سوءاستفاده میتواند آغاز فرایند پاسخ به رخداد را ضروری کند.
باجافزار (Ransomware)
باجافزار میتواند باعث رمزگذاری اطلاعات، اختلال در عملکرد سرویسها یا تهدید به انتشار داده شود.
پاسخ به این حادثه باید بر مهار، حفظ شواهد، بررسی دامنه آلودگی، محافظت از نسخههای پشتیبان و بازیابی از منابع قابلاعتماد متمرکز باشد.
تغییر غیرمجاز صفحات سایت
در حمله Website Defacement محتوای صفحات بدون مجوز تغییر میکند.
بازگرداندن ظاهر سایت کافی نیست؛ زیرا تغییر صفحه میتواند نشانه دسترسی گستردهتر مهاجم به سیستم باشد.
حملات زنجیره تأمین (Supply Chain)
گاهی منشأ حادثه، یک افزونه، کتابخانه نرمافزاری، سرویس خارجی یا حساب توسعهدهنده است.
در این شرایط لازم است علاوه بر سایت، وابستگیهای نرمافزاری و سرویسهای مرتبط نیز بررسی شوند. 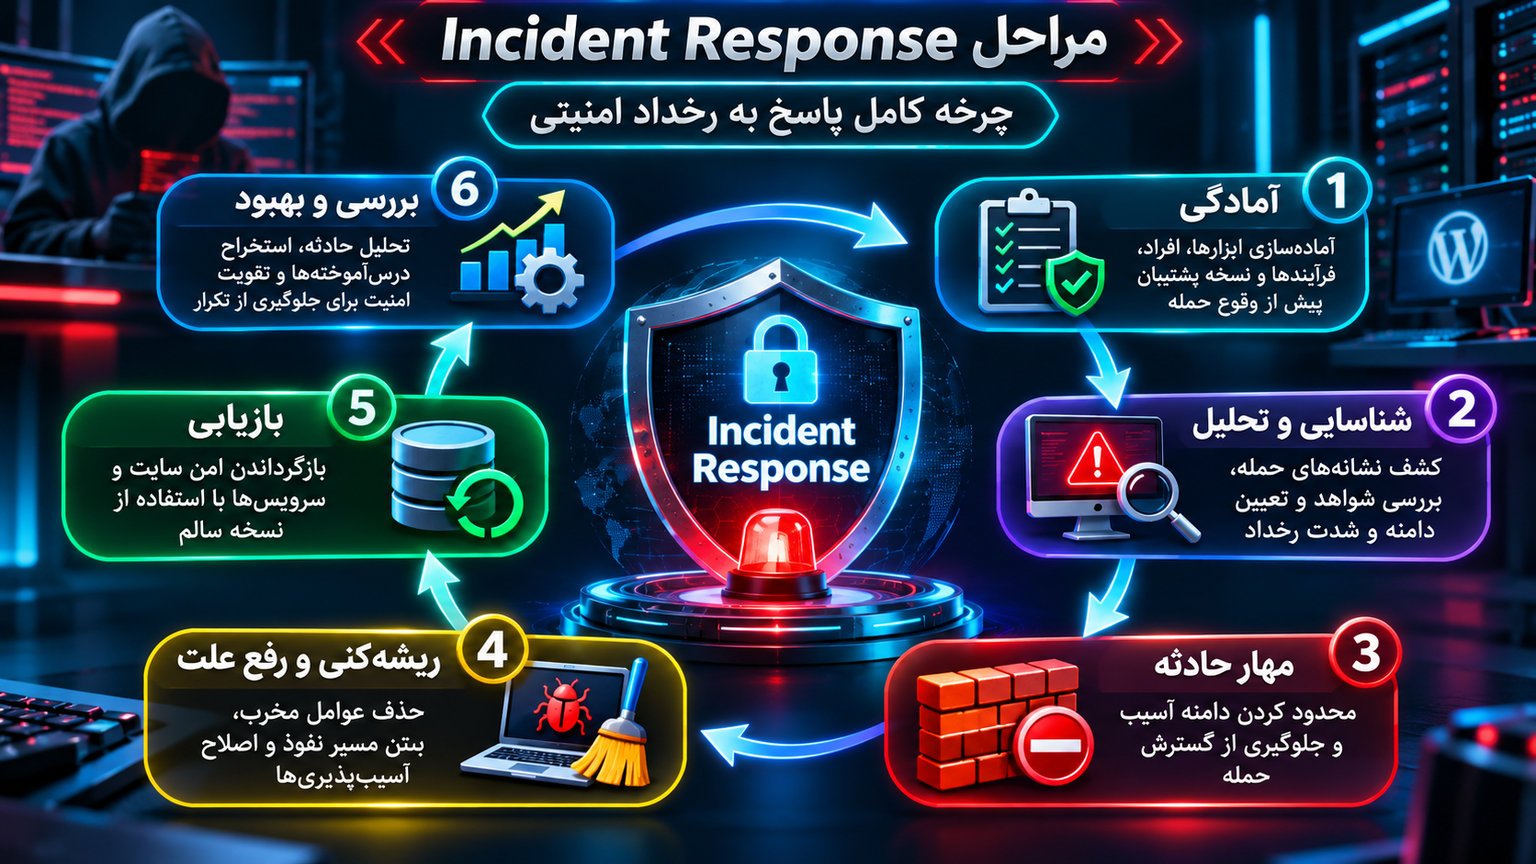
مراحل Incident Response؛ چرخه کامل پاسخ به رخداد امنیتی
فرایند پاسخ به رخداد در مدلهای مختلف با تقسیمبندیهای متفاوت توضیح داده میشود.
در مدلهای عملیاتی رایج، مراحل آمادگی، شناسایی، مهار، ریشهکنی، بازیابی و بررسی پس از حادثه مطرح هستند.
در چارچوب جدیدتر NIST SP 800-61 Revision 3 نیز فعالیتهای اصلی پاسخ به رخداد با قابلیتهای Detect، Respond و Recover در چارچوب امنیت سایبری CSF 2.0 هماهنگ شدهاند. فعالیتهای Govern، Identify و Protect از آمادگی و مدیریت ریسک پشتیبانی میکنند و بهبود مستمر در سراسر چرخه جریان دارد.
برای کاربرد عملی در مدیریت وبسایت، میتوان فرایند را به شش مرحله زیر تقسیم کرد.
مرحله اول: آمادگی (Preparation)
آمادگی یعنی پیش از وقوع حادثه، ابزارها، اطلاعات و مسئولیتهای لازم را مشخص کرده باشید.
در این مرحله باید بدانید چه کسی مسئول بررسی هشدارهاست، چه زمانی با هاستینگ تماس گرفته میشود و کدام اقدامات بدون تأیید مدیر اصلی مجاز هستند.
مهمترین فعالیتهای آمادگی عبارتاند از:
- شناسایی داراییهای مهم سایت و زیرساخت
- تعیین مسئولان پاسخ به رخداد
- تهیه برنامه مکتوب Incident Response Plan
- فعالسازی ثبت گزارشهای امنیتی
- راهاندازی هشدارهای مهم
- نگهداری نسخههای پشتیبان مستقل
- تعریف سیاست دسترسی کاربران
- آموزش کارکنان و آزمایش سناریوهای اضطراری
آمادگی مناسب، زمان تصمیمگیری را کاهش میدهد و از وابستگی کامل به یک فرد جلوگیری میکند.
مرحله دوم: شناسایی و تحلیل (Detection and Analysis)
در این مرحله تلاش میشود نشانههای حمله شناسایی شده و اعتبار آنها بررسی شود.
منابع اطلاعاتی میتوانند شامل گزارشهای وبسرور، لاگ برنامه، فعالیت حسابهای مدیریتی، هشدارهای WAF، تغییرات فایلها و گزارشهای شرکت هاستینگ باشند.
برای مثال، ایجاد یک کاربر مدیر جدید همراه با ورود از موقعیتی غیرمعمول و تغییر فایلهای حساس، میتواند نشانهای از دسترسی غیرمجاز باشد.
هدف تحلیل این است که مشخص شود:
- چه اتفاقی رخ داده است؟
- نخستین نشانه قابلشناسایی چه زمانی ثبت شده است؟
- کدام حسابها یا سیستمها تحتتأثیر قرار گرفتهاند؟
- آیا حادثه همچنان فعال است؟
- چه دادههایی ممکن است در معرض خطر قرار گرفته باشند؟
- میزان اطمینان به شواهد موجود چقدر است؟
در این مرحله نباید بر اساس یک نشانه منفرد، نتیجه قطعی درباره منشأ یا وسعت حمله گرفت.
مرحله سوم: مهار حادثه (Containment)
هدف مهار، محدودکردن دامنه آسیب و جلوگیری از ادامه فعالیت غیرمجاز است.
بسته به نوع حادثه، مهار میتواند شامل غیرفعالکردن یک حساب، محدودسازی دسترسی به یک سرویس، قرنطینه محیط آسیبدیده یا اعمال کنترل موقت روی ترافیک باشد.
برای نمونه، اگر حساب مدیر وردپرس تصاحب شده باشد، لغو نشستهای فعال و محدودکردن دسترسی آن حساب میتواند بخشی از برنامه مهار باشد.
البته ترتیب اقدامات اهمیت دارد. تغییر ناگهانی تنظیمات ممکن است موجب حذف برخی شواهد یا آگاهشدن مهاجم از روند بررسی شود.
در حوادث جدی باید میان سرعت مهار، حفظ شواهد و تداوم خدمات تعادل برقرار شود.
مرحله چهارم: ریشهکنی و رفع علت (Eradication)
پس از کنترل وضعیت، نوبت به حذف عوامل ایجادکننده حادثه میرسد.
اگر آلودگی بهدلیل یک افزونه آسیبپذیر رخ داده باشد، حذف فایل مخرب بدون اصلاح آسیبپذیری کافی نیست.
اقدامات این مرحله ممکن است شامل بازسازی بخشهای آلوده از منابع معتبر، حذف حسابهای غیرمجاز، اصلاح تنظیمات و بهروزرسانی اجزای آسیبپذیر باشند.
همچنین باید بررسی شود که مهاجم روش دسترسی دیگری ایجاد نکرده باشد.
برای مثال، وجود حسابهای ناشناس، کلیدهای دسترسی غیرمجاز یا تغییرات مشکوک در تنظیمات زمانبندیشده میتواند احتمال بازگشت مهاجم را افزایش دهد.
مرحله پنجم: بازیابی (Recovery)
بازیابی به معنای بازگرداندن سیستم به وضعیت عملیاتی امن و قابلاعتماد است.
در این مرحله ممکن است نسخه سالم سایت روی محیط پاک نصب شود، دادههای معتبر بازگردانده شوند و دسترسی کاربران بهتدریج فعال شود.
پیش از بازگشت کامل سایت باید عملکرد بخشهای مهم بررسی گردد.
برای یک فروشگاه اینترنتی، نمایش صحیح صفحات بهتنهایی کافی نیست. فرایند ثبت سفارش، محاسبه مبلغ، پرداخت، ارسال ایمیل و مدیریت حساب مشتری نیز باید آزمایش شوند.
پس از راهاندازی مجدد، پایش شدیدتر برای شناسایی نشانههای بازگشت تهدید ضروری است.
مرحله ششم: بررسی حادثه و بهبود مستمر (Lessons Learned)
پایان اختلال فنی به معنای پایان فرایند Incident Response نیست.
پس از حادثه باید بررسی شود چه عواملی باعث وقوع آن شدهاند و کدام کنترلها عملکرد مناسبی نداشتهاند.
پرسشهای کلیدی این مرحله شامل موارد زیر هستند:
- چرا حادثه زودتر شناسایی نشد؟
- کدام اقدامات باعث کاهش یا افزایش خسارت شدند؟
- آیا نسخه پشتیبان سالم و قابلبازیابی بود؟
- آیا مسئولیتها بهروشنی تعریف شده بودند؟
- چه اصلاحاتی از تکرار رخداد جلوگیری میکنند؟
نتایج این بررسی باید به تغییرات مشخص، دارای مسئول و زمانبندی تبدیل شوند. 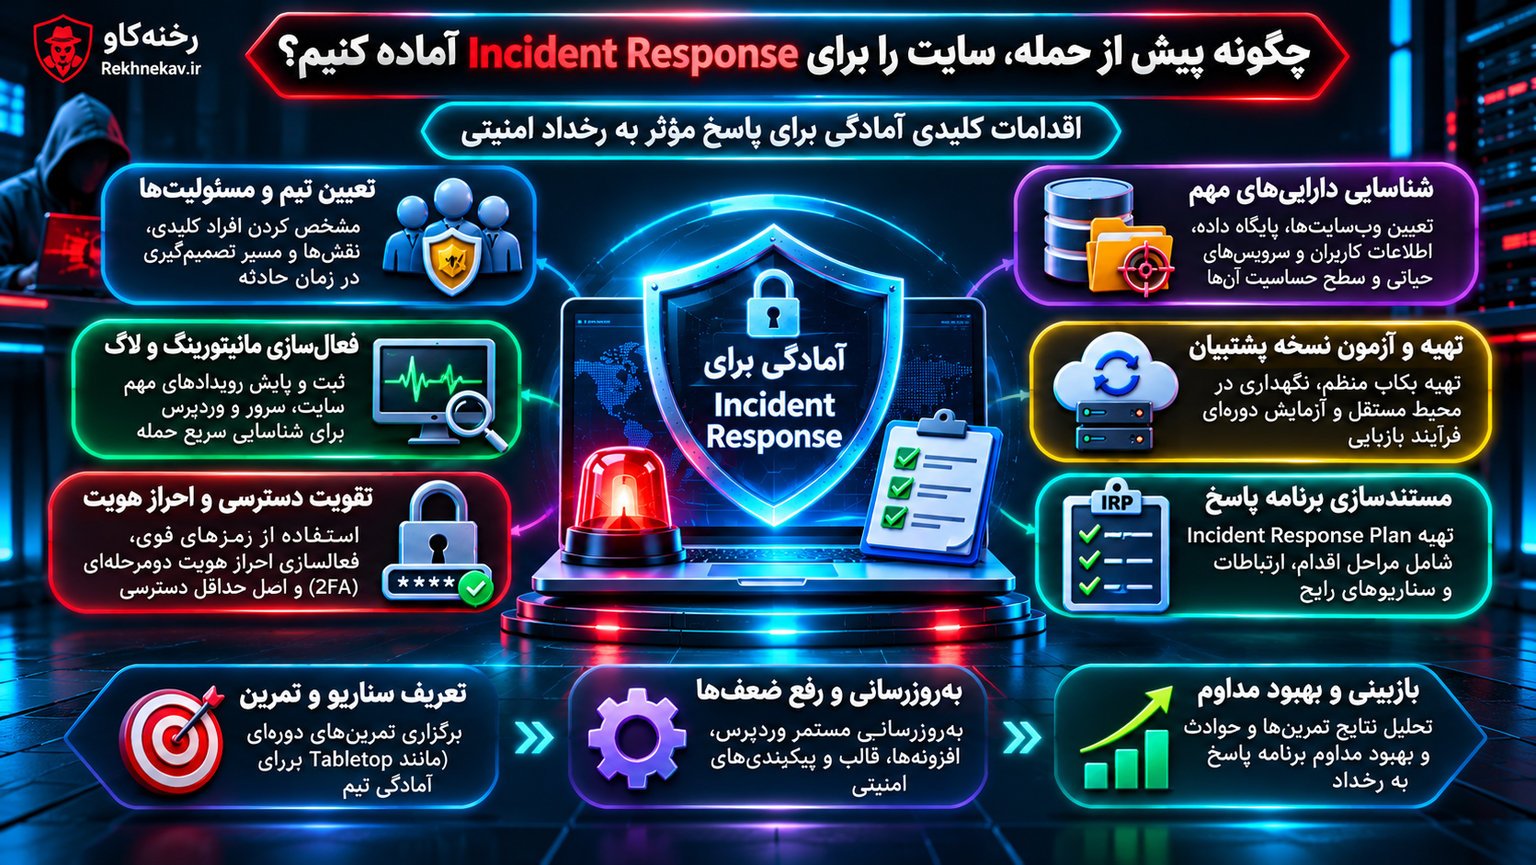
چگونه پیش از حمله، سایت را برای Incident Response آماده کنیم؟
یکی از اشتباهات رایج این است که مدیر سایت تازه پس از وقوع نفوذ به فکر جمعآوری اطلاعات و تعیین فرایند پاسخ میافتد.
درحالیکه بخش مهمی از موفقیت Incident Response به اقدامات قبل از حادثه وابسته است.
شناسایی داراییهای حیاتی سایت
ابتدا باید مشخص کنید چه داراییهایی برای عملکرد سایت ضروری هستند.
برای مثال:
- دامنه و تنظیمات DNS
- حساب هاستینگ یا سرور
- فایلها و کدهای برنامه
- پایگاه داده
- پنل مدیریت وردپرس
- حسابهای مدیران و توسعهدهندگان
- فضای ذخیرهسازی فایلها
- سرویس ایمیل
- CDN و فایروال
- درگاه پرداخت و سرویسهای متصل
- مخزن کد و سامانه استقرار
- نسخههای پشتیبان
برای هر دارایی، مالک، روش دسترسی، سطح اهمیت و وابستگیهای آن را مشخص کنید.
این فهرست هنگام حادثه کمک میکند هیچ بخش مهمی از بررسی جا نماند.
تعیین سطح حساسیت اطلاعات
همه دادهها اهمیت یکسانی ندارند.
برای مثال، تغییر یک تصویر عمومی سایت با دسترسی غیرمجاز به پایگاه داده مشتریان از نظر پیامدهای امنیتی متفاوت است.
اطلاعات را میتوان به گروههای عمومی، داخلی، محرمانه و بسیار حساس تقسیم کرد.
این دستهبندی به اولویتبندی اقدامات و تعیین الزامات حفاظتی کمک میکند.
شناسایی وابستگیهای خارجی
بسیاری از وبسایتها به سرویسهایی وابستهاند که خارج از کنترل مستقیم مدیر سایت قرار دارند.
شرکت هاستینگ، ارائهدهنده DNS، درگاه پرداخت، سامانه ارسال پیامک و سرویس ایمیل نمونههایی از این وابستگیها هستند.
در برنامه پاسخ باید اطلاعات تماس اضطراری، روش احراز هویت برای دریافت پشتیبانی و محدوده مسئولیت هر ارائهدهنده ثبت شود.
ثبت معماری و مسیرهای دسترسی
وجود یک دیاگرام ساده از معماری سایت میتواند بررسی حادثه را سریعتر کند.
این دیاگرام بهتر است مسیر ارتباط کاربر با CDN، وبسرور، برنامه، پایگاه داده و سرویسهای خارجی را نشان دهد.
همچنین باید مشخص باشد کدام حسابها امکان تغییر تنظیمات زیرساخت را دارند.
تدوین برنامه Incident Response Plan برای وبسایت
برنامه پاسخ به رخداد یا IRP سندی است که نحوه تصمیمگیری و اجرای اقدامات هنگام حوادث امنیتی را مشخص میکند.
این سند نباید صرفاً مجموعهای از توصیههای عمومی باشد. یک برنامه قابلاستفاده باید با معماری، منابع انسانی و سطح ریسک سایت هماهنگ باشد.
اجزای ضروری برنامه
یک Incident Response Plan مناسب حداقل شامل موارد زیر است:
هدف و دامنه: مشخص کند برنامه شامل کدام وبسایتها، سرورها، سرویسهای خارجی و اطلاعات میشود.
معیار اعلام حادثه: تعیین کند چه شرایطی نیازمند فعالسازی برنامه است.
نقشها و مسئولیتها: مشخص کند چه کسی مسئول بررسی، تأیید، اجرا و ارتباطات است.
روش اولویتبندی: سطح شدت حوادث را بر اساس پیامدهای واقعی تعیین کند.
مراحل عملیاتی: نحوه شناسایی، مهار، ریشهکنی و بازیابی را تعریف کند.
مدیریت شواهد: شیوه نگهداری گزارشها و اطلاعات مربوط به حادثه را توضیح دهد.
ارتباطات: نحوه اطلاعرسانی به مدیریت، کاربران، ارائهدهندگان خدمات و سایر طرفهای مرتبط را مشخص کند.
شرایط پایان حادثه: معیارهای بازگشت ایمن سرویس و خاتمه پاسخ عملیاتی را تعیین کند.
چرا برنامه باید ساده و قابلاجرا باشد؟
یک سند بسیار طولانی که هیچکس در زمان بحران نتواند از آن استفاده کند، ارزش عملی محدودی دارد.
بهتر است علاوه بر برنامه کامل، یک نسخه کوتاه اضطراری تهیه شود که شماره تماسها، مسئول تصمیمگیری و اقدامات اولیه را مشخص کند.
اطلاعات حیاتی برنامه باید در محلی امن و مستقل از سایت اصلی نیز قابلدسترسی باشند.
تشکیل تیم پاسخ به رخداد امنیتی (CSIRT)
در سازمانهای بزرگ، مدیریت حوادث معمولاً توسط گروهی با عنوان Computer Security Incident Response Team یا CSIRT انجام میشود.
این تیم میتواند شامل متخصصان امنیت، مدیران سیستم، توسعهدهندگان، مسئولان شبکه و نمایندگان مدیریت باشد.
اما برای یک وبسایت کوچک نیز میتوان ساختار سادهای تعریف کرد.
نقشهای مهم در تیم پاسخ
هماهنگکننده حادثه: مسئول مدیریت کلی، اولویتبندی فعالیتها و ثبت تصمیمهای مهم است.
مسئول فنی: شواهد را بررسی میکند و اقدامات مهار و بازیابی را با هماهنگی سایر افراد انجام میدهد.
مسئول زیرساخت: تنظیمات هاست، سرور، شبکه، DNS و سرویسهای وابسته را مدیریت میکند.
مسئول ارتباطات: اطلاعات تأییدشده را به ذینفعان منتقل میکند.
مسئول کسبوکار یا مدیریت: درباره تصمیمهایی مانند توقف فروش، فعالسازی محیط جایگزین و تخصیص منابع تصمیم میگیرد.
در یک کسبوکار کوچک ممکن است چند نقش بر عهده یک نفر باشد، اما همچنان باید مسئول اصلی و جانشین مشخص باشند. 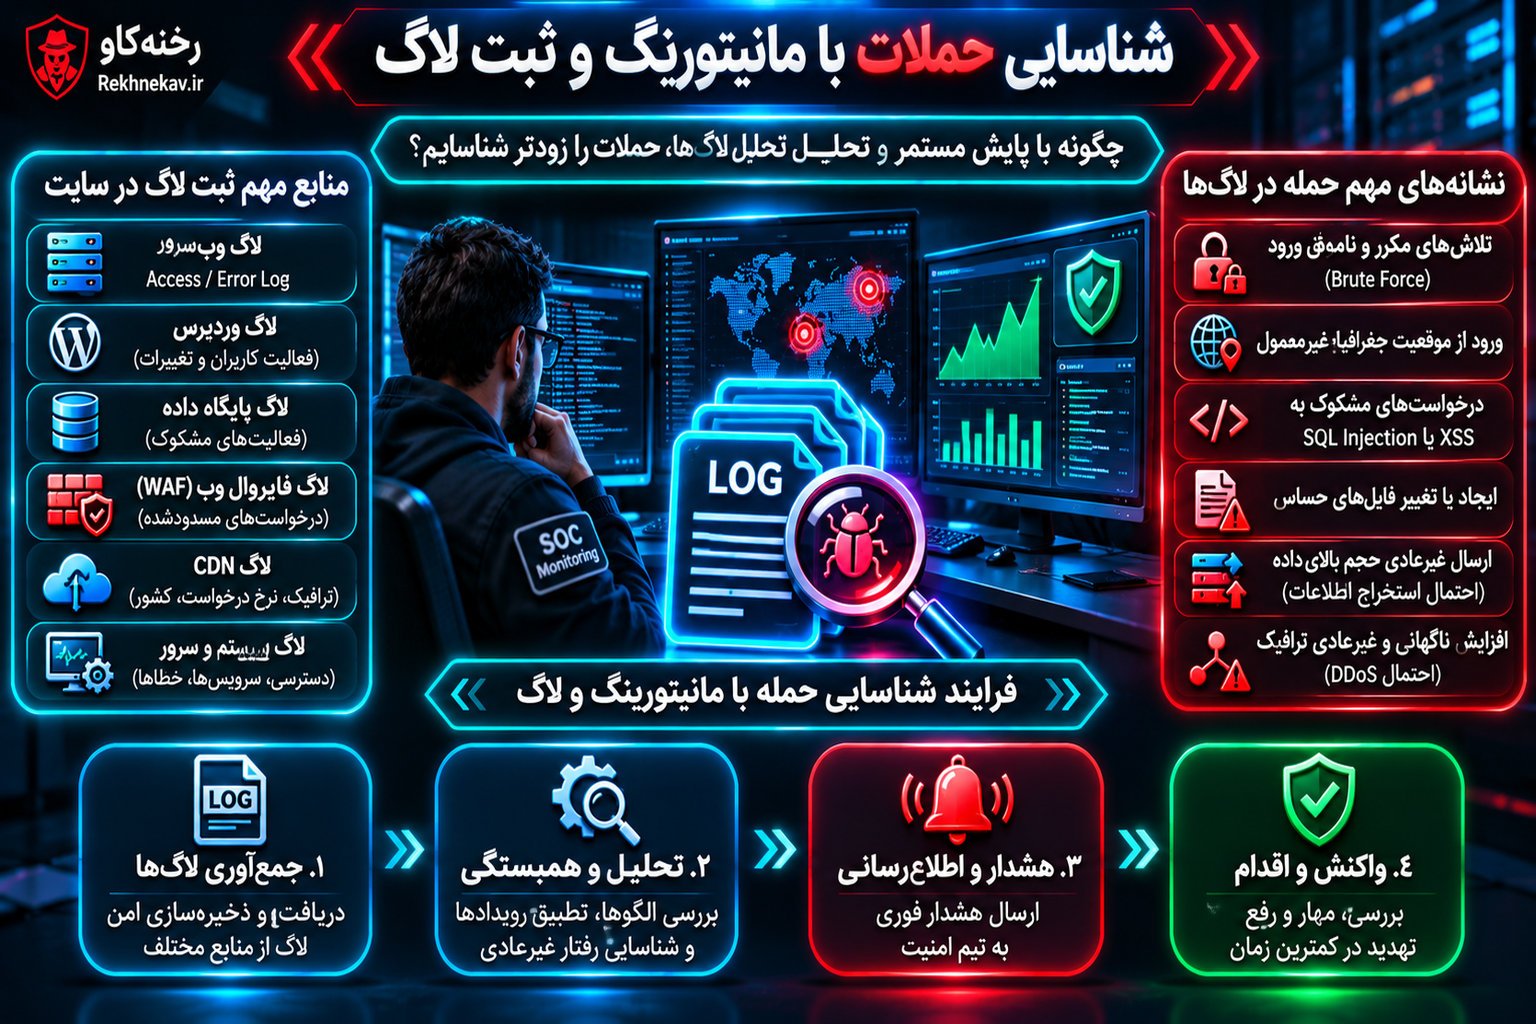
شناسایی حملات با مانیتورینگ و ثبت لاگ
بدون دادههای نظارتی، تشخیص زمان شروع حمله و بررسی دامنه آسیب بسیار دشوار میشود.
ثبت گزارش یا Logging یکی از مهمترین زیرساختهای Incident Response است.
چه گزارشهایی باید ثبت شوند؟
برای یک وبسایت، منابع زیر اهمیت زیادی دارند:
- گزارش دسترسی وبسرور یا Access Log
- گزارش خطاهای برنامه و سرور
- رویدادهای ورود و خروج کاربران
- فعالیت حسابهای مدیریتی
- تغییر نقش و سطح دسترسی کاربران
- نصب، حذف و بهروزرسانی افزونهها
- تغییر فایلها و تنظیمات حساس
- هشدارهای WAF و CDN
- فعالیتهای امنیتی پایگاه داده در صورت پشتیبانی
- رویدادهای زیرساخت و سرویسهای ابری
ترکیب این دادهها میتواند تصویری دقیقتر از حادثه ایجاد کند.
چرا لاگ وبسرور بهتنهایی کافی نیست؟
گزارش وبسرور معمولاً اطلاعاتی درباره درخواستها، زمان پاسخ، آدرسهای شبکه و وضعیت پاسخ ارائه میدهد.
اما این دادهها همیشه مشخص نمیکنند یک درخواست در سطح برنامه چه تغییری ایجاد کرده است.
برای مثال، مشاهده یک درخواست موفق لزوماً نشان نمیدهد کدام تنظیم مدیریتی تغییر کرده است.
به همین دلیل، ثبت رویدادهای امنیتی در سطح برنامه و ایجاد ارتباط میان آنها اهمیت دارد.
حفاظت از گزارشها
گزارشهای امنیتی باید در برابر حذف، تغییر و دسترسی غیرمجاز محافظت شوند.
در صورت امکان، نسخهای از رویدادهای مهم به سامانهای مستقل و دارای کنترل دسترسی ارسال شود.
همچنین همگامسازی ساعت سیستمها ضروری است؛ زیرا اختلاف زمانی میان سرویسها میتواند بازسازی توالی حادثه را دشوار کند.
در طراحی ثبت لاگ باید از ذخیره غیرضروری رمزهای عبور، توکنهای حساس و اطلاعات شخصی جلوگیری شود.
استفاده از SIEM و هشدارهای هوشمند
سامانه Security Information and Event Management یا SIEM اطلاعات امنیتی منابع مختلف را تجمیع و تحلیل میکند.
این ابزار میتواند به شناسایی الگوهای غیرعادی کمک کند؛ اما داشتن SIEM بهتنهایی تضمینکننده تشخیص همه حملات نیست.
برای سایتهای کوچک، حتی ترکیبی از هشدارهای هاستینگ، مانیتورینگ فایلها، گزارش فعالیت مدیران و اعلانهای امنیتی میتواند نقطه شروع مناسبی باشد.
مهمتر از تعداد ابزارها، کیفیت هشدارها و وجود فرد مسئول برای بررسی آنهاست.
نشانههای مهم وقوع رخداد امنیتی در سایت
برخی رفتارها میتوانند نشاندهنده یک مشکل امنیتی باشند و باید بررسی شوند.
تغییرات غیرمنتظره در فایلها
ایجاد فایل ناشناس یا تغییر فایل حساس خارج از فرایند انتشار عادی، یک نشانه مهم است.
البته تمام تغییرات فایل مخرب نیستند. نصب افزونه، بهروزرسانی و فعالیت سیستمهای کش نیز میتوانند تغییرات قانونی ایجاد کنند.
ایجاد حسابهای مدیریتی ناشناس
وجود کاربر جدید با سطح دسترسی مدیر، بدون درخواست یا تأیید مسئول سایت، نیازمند بررسی فوری است.
تغییر مسیر بازدیدکنندگان
هدایت ناخواسته کاربران به دامنههای دیگر ممکن است ناشی از تغییرات مخرب در تنظیمات، فایلها یا پایگاه داده باشد.
افزایش غیرعادی درخواستها
افزایش ناگهانی درخواستها ممکن است به حمله خودکار، رفتار خزندهها، افزایش واقعی بازدید یا مشکل نرمافزاری مربوط باشد.
برای تصمیمگیری باید دادههای تکمیلی بررسی شوند.
هشدار موتورهای جستوجو
اعلام شناسایی بدافزار یا محتوای فریبنده در یک دامنه میتواند نشانه آلودگی باشد.
تغییرات مشکوک در ایمیل و حسابها
ارسال پیامهای ناخواسته، تغییر آدرس ایمیل بازیابی یا ایجاد کلیدهای دسترسی ناشناس نیز میتوانند با یک رخداد امنیتی ارتباط داشته باشند.
هیچکدام از این نشانهها بهتنهایی جایگزین تحلیل فنی نمیشوند.
اولویتبندی رخدادها براساس شدت و تأثیر
همه حوادث به واکنش یکسان نیاز ندارند.
برای نمونه، شناسایی چند تلاش ناموفق ورود با مشاهده دسترسی غیرمجاز به اطلاعات مشتریان قابلمقایسه نیست.
یکی از روشهای عملی، تقسیم رخدادها به چهار سطح است.
| سطح | شدت | نمونه | اولویت رسیدگی |
|---|---|---|---|
| P1 | بحرانی | احتمال افشای گسترده داده یا نفوذ فعال به زیرساخت حیاتی | فوری |
| P2 | بالا | تصاحب حساب مدیریتی یا آلودگی تأییدشده بخشی از سایت | بسیار بالا |
| P3 | متوسط | فعالیت مشکوک محدود که نیازمند بررسی تخصصی است | برنامهریزی سریع |
| P4 | پایین | هشدار کمخطر بدون شواهد آسیب فعلی | پایش و بررسی معمول |
این جدول یک نمونه پیشنهادی است و باید با شرایط واقعی هر سازمان تطبیق داده شود.
برای اولویتبندی دقیقتر، محرمانگی دادهها، گستره دسترسی، احتمال گسترش حادثه، تأثیر مالی و حساسیت سرویس را در نظر بگیرید.
شدت حادثه نیز ممکن است با کشف شواهد جدید تغییر کند. 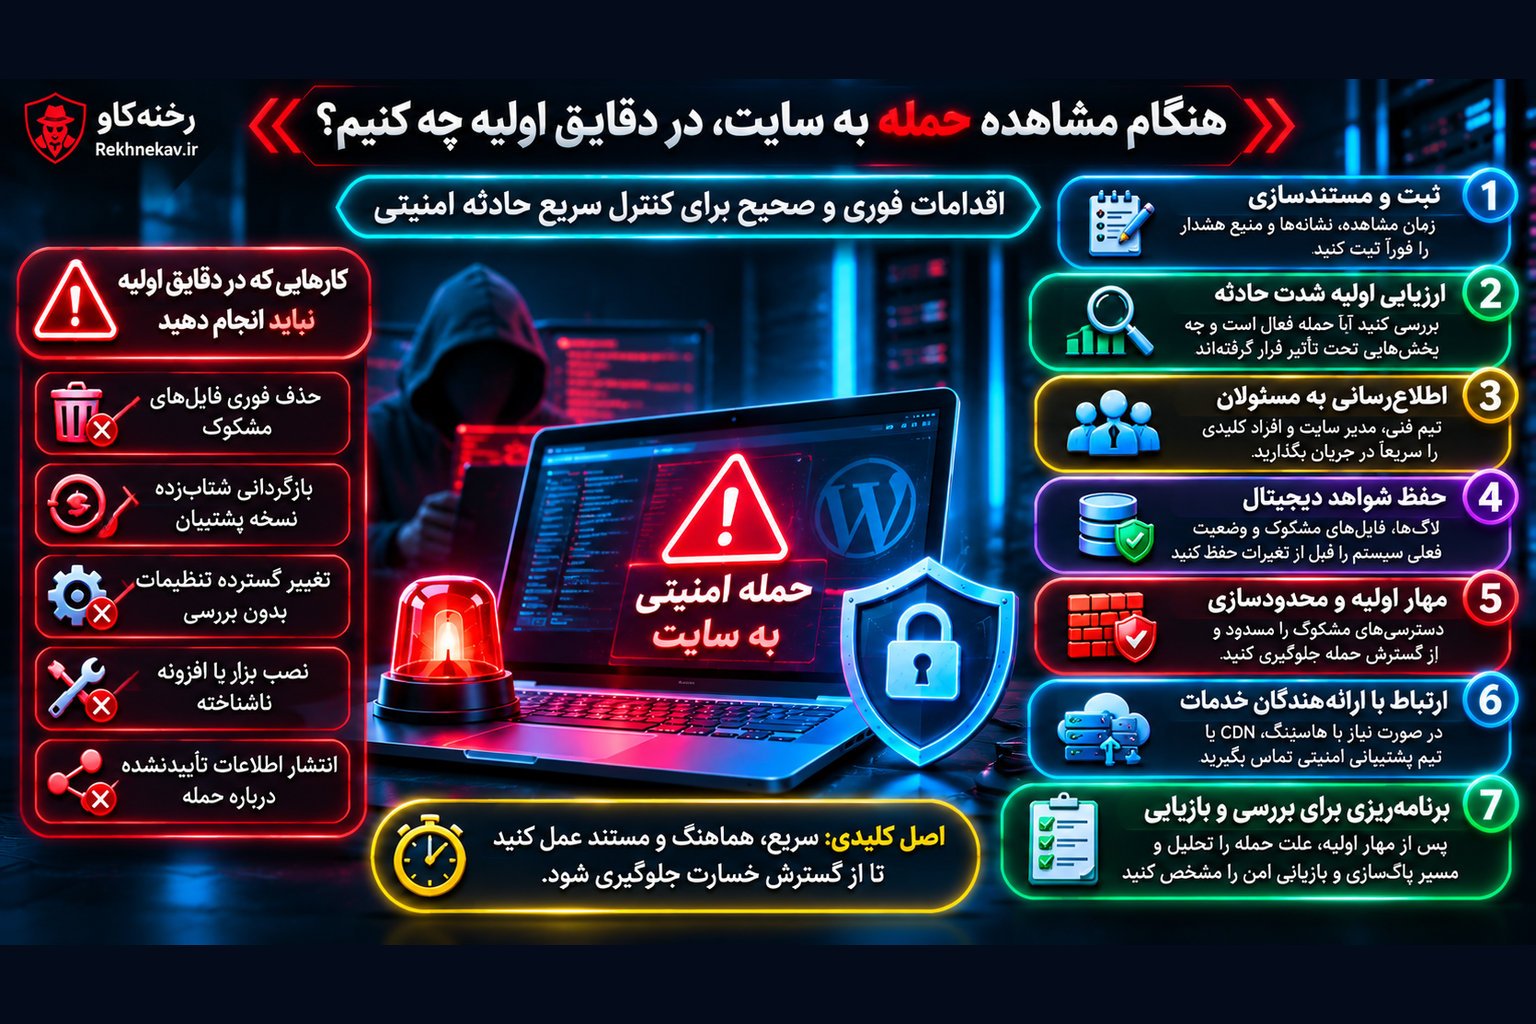
هنگام مشاهده حمله به سایت، در دقایق اولیه چه کار کنیم؟
دقایق ابتدایی یک رخداد امنیتی برای جلوگیری از خسارت اهمیت زیادی دارند.
بااینحال، انجام اقدامات عجولانه میتواند شواهد را از بین ببرد یا باعث اختلال بیشتر شود.
گام اول: مشاهده را ثبت کنید
زمان مشاهده مشکل، نشانههای قابلمشاهده و منبع هشدار را ثبت کنید.
برای مثال، مشخص کنید چه صفحهای تغییر کرده، کدام سامانه هشدار داده و چه زمانی نخستین رفتار غیرعادی دیده شده است.
گام دوم: شدت حادثه را ارزیابی کنید
بررسی کنید آیا حمله همچنان فعال است، اطلاعات حساس در معرض خطر قرار دارند یا سرویس حیاتی از دسترس خارج شده است.
گام سوم: مسئول پاسخ را مطلع کنید
اگر سایت توسط چند نفر مدیریت میشود، هماهنگی از طریق مسیر ارتباطی مشخص انجام شود.
گام چهارم: شواهد در معرض حذف را حفظ کنید
در صورت امکان و متناسب با فوریت حادثه، گزارشها و تصاویر وضعیت سیستم را پیش از تغییرات گسترده ثبت کنید.
اگر ادامه فعالیت مهاجم به آسیب فوری منجر میشود، مهار اضطراری ممکن است بر جمعآوری کامل شواهد مقدم باشد؛ اما تصمیم و اقدامات انجامشده باید ثبت شوند.
گام پنجم: دسترسیهای خطرناک را محدود کنید
اقدامات محدودسازی باید متناسب با ماهیت حادثه و با درنظرگرفتن تأثیر آن بر سرویس انجام شوند.
گام ششم: ارتباط با ارائهدهندگان خدمات را برقرار کنید
در صورت نیاز، موضوع را به هاستینگ، ارائهدهنده CDN یا تیم پشتیبانی امنیتی اطلاع دهید.
گام هفتم: از بازگردانی شتابزده خودداری کنید
تا زمانی که علت و دامنه حادثه بهاندازه کافی بررسی نشده است، بازگردانی ساده آخرین نسخه پشتیبان ممکن است آلودگی را دوباره وارد محیط کند.
حفظ شواهد دیجیتال در Incident Response
یکی از مهمترین تفاوتهای پاسخ حرفهای به رخداد با رفع مشکل معمولی، توجه به حفظ شواهد است.
شواهد دیجیتال میتوانند برای شناسایی علت حمله، بررسی دامنه دسترسی و پاسخگویی به الزامات حقوقی اهمیت داشته باشند.
چه اطلاعاتی ارزش حفظ دارند؟
بسته به شرایط، موارد زیر ممکن است ضروری باشند:
- گزارشهای مربوط به زمان حادثه
- اطلاعات حسابهای مشکوک
- فهرست تغییرات فایلها
- تصاویر و خروجیهای وضعیت سیستم
- نسخههای مناسب از فایلهای آلوده
- تنظیمات امنیتی مرتبط
- اطلاعات مربوط به درخواستهای غیرمعمول
- تاریخچه تغییرات مدیریتی
جمعآوری این دادهها باید با رعایت مجوزهای دسترسی و الزامات محرمانگی انجام شود.
زنجیره نگهداری شواهد چیست؟
Chain of Custody به ثبت نحوه جمعآوری، انتقال، نگهداری و دسترسی به شواهد اشاره دارد.
برای هر مدرک مهم بهتر است زمان جمعآوری، مسئول، محل نگهداری و اقدامات انجامشده ثبت شود.
استفاده از هش رمزنگاریشده مناسب میتواند به تشخیص تغییرات بعدی فایل کمک کند.
هش بهتنهایی اصالت مدرک یا قانونیبودن فرایند جمعآوری را اثبات نمیکند؛ بلکه یکی از ابزارهای بررسی یکپارچگی است.
چرا نباید فایلهای مشکوک فوراً حذف شوند؟
حذف فایل ممکن است اطلاعات ارزشمندی درباره زمان ایجاد، ارتباط آن با سایر فایلها و ماهیت حادثه را از بین ببرد.
در موارد مهم، بررسی توسط متخصص پاسخ به رخداد و جرمیابی دیجیتال یا Digital Forensics مناسبتر است.
مهار حمله بدون ایجاد خسارت بیشتر
مهار حادثه باید بهاندازه کافی سریع باشد، اما نباید بدون بررسی پیامدها انجام شود.
برای مثال، قطع کامل سرور ممکن است فعالیت مخرب را متوقف کند، ولی همزمان سایت را از دسترس خارج کند و بعضی دادههای موقت برای بررسی از بین بروند.
از سوی دیگر، فعال نگهداشتن سیستم آلوده نیز میتواند خطرناک باشد.
انتخاب روش مهار به شدت حادثه، نوع دسترسی مهاجم و ارزش شواهد بستگی دارد.
مهار کوتاهمدت
مهار کوتاهمدت برای محدودکردن فوری آسیب استفاده میشود.
نمونهها شامل محدودسازی حساب مشکوک، مسدودسازی یک مسیر آسیبپذیر یا اعمال کنترل موقت روی ترافیک است.
مهار بلندمدت
در مهار بلندمدت تلاش میشود تا زمان تکمیل پاکسازی، محیط در وضعیت قابلکنترل باقی بماند.
برای نمونه، ممکن است دسترسی مدیریتی تنها از مسیر امن و مشخص مجاز باشد یا بخشی از قابلیتهای سایت موقتاً غیرفعال شود.
نقش WAF در مهار حادثه
Web Application Firewall یا WAF میتواند برخی درخواستهای مخرب را پیش از رسیدن به برنامه شناسایی یا محدود کند.
در حملات خاص، تغییر قواعد WAF ممکن است به کاهش فعالیت مهاجم کمک کند.
بااینحال، WAF جایگزین اصلاح آسیبپذیری یا بررسی دسترسیهای غیرمجاز نیست.
ریشهیابی علت اصلی حادثه (Root Cause Analysis)
اگر علت اصلی رخداد مشخص نشود، احتمال تکرار آن وجود دارد.
Root Cause Analysis یا RCA فرایندی است که تلاش میکند عوامل فنی و عملیاتی ایجادکننده حادثه را شناسایی کند.
برای مثال، فرض کنید مهاجم توانسته محتوای سایت را تغییر دهد.
ممکن است بررسی نشان دهد علت مستقیم، دسترسی غیرمجاز به حساب مدیر بوده است.
اما بررسی عمیقتر میتواند مشخص کند اطلاعات ورود از طریق فیشینگ افشا شده، احراز هویت دومرحلهای فعال نبوده و هشدار ورود غیرمعمول نیز وجود نداشته است.
در چنین وضعیتی، بازنشانی رمز عبور فقط بخشی از راهکار است.
برای جلوگیری از تکرار حادثه باید روش احراز هویت، آموزش کاربران و سامانه هشدار نیز اصلاح شوند.
در تحلیل ریشهای بهتر است میان موارد زیر تفاوت قائل شوید:
- علت اصلی: عاملی که وقوع حادثه را ممکن کرده است.
- مسیر حمله: روشی که مهاجم برای دستیابی به هدف استفاده کرده است.
- عوامل تشدیدکننده: ضعفهایی که باعث افزایش خسارت شدهاند.
- نقاط ضعف کشف: عواملی که شناسایی حادثه را به تأخیر انداختهاند.
گاهی بهدلیل نبود گزارش کافی، علت اصلی با قطعیت مشخص نمیشود. در این شرایط باید سطح اطمینان نتایج بهصراحت بیان شود.
بازیابی امن سایت پس از حمله
بازیابی یکی از حساسترین مراحل Incident Response است؛ زیرا بازگشت سریع سایت بدون رفع علت حادثه میتواند به آلودگی مجدد منجر شود.
انتخاب نقطه بازیابی سالم
هر نسخه پشتیبان الزاماً سالم نیست.
اگر آلودگی چند هفته پیش آغاز شده باشد، ممکن است چند نسخه پشتیبان اخیر نیز شامل تغییرات مخرب باشند.
بنابراین باید بازه احتمالی نفوذ بررسی شود و نقطه بازیابی با اطمینان مناسب انتخاب گردد.
استفاده از محیط پاک
در حوادث جدی، بازسازی سیستم در محیطی تازه و قابلاعتماد معمولاً از ادامه استفاده از محیطی که یکپارچگی آن نامشخص است، قابلاطمینانتر خواهد بود.
نسخههای نرمافزاری باید از منابع معتبر تأمین شوند و تنظیمات امنیتی پیش از انتشار بررسی شوند.
بازنشانی اطلاعات احراز هویت
اگر احتمال دسترسی مهاجم به اطلاعات احراز هویت وجود دارد، لازم است گذرواژهها، نشستهای فعال، کلیدهای API و سایر اعتبارنامههای مرتبط بررسی و در صورت نیاز باطل یا جایگزین شوند.
این کار باید از دستگاه و مسیر مدیریتی قابلاعتماد انجام شود.
آزمایش عملکرد سایت
پس از بازیابی، صفحات عمومی، ورود کاربران، فرمها، ارتباطات خارجی و عملکردهای حیاتی باید بررسی شوند.
همچنین باید اطمینان حاصل شود دادههای بازیابیشده با شرایط عملیاتی کسبوکار سازگارند.
پایش پس از بازیابی
پس از بازگرداندن سرویس، نظارت بر فعالیتهای مشکوک باید ادامه پیدا کند.
هدف این است که نشانههای دسترسی مجدد مهاجم، خطاهای جدید یا رفتار غیرعادی در کوتاهترین زمان ممکن بررسی شوند.
نقش نسخه پشتیبان در Incident Response
نسخه پشتیبان یا Backup یکی از مهمترین ابزارهای بازیابی است، اما جایگزین برنامه پاسخ به رخداد محسوب نمیشود.
یک پشتیبان مناسب باید علاوه بر وجود فایل، از نظر قابلیت بازیابی و سلامت دادهها نیز آزمایش شده باشد.
اصل 3-2-1 در پشتیبانگیری
روش 3-2-1 یک الگوی شناختهشده برای کاهش خطر از دست رفتن دادههاست:
- سه نسخه از دادههای مهم نگهداری شود.
- نسخهها در حد امکان روی دو نوع رسانه یا محیط ذخیرهسازی مستقل قرار گیرند.
- دستکم یک نسخه خارج از محیط اصلی نگهداری شود.
برای مقاومت بیشتر در برابر باجافزار، استفاده از نسخههای غیرقابلتغییر (Immutable) یا آفلاین نیز میتواند مفید باشد.
تفاوت RPO و RTO
دو مفهوم مهم در برنامه بازیابی عبارتاند از:
Recovery Point Objective یا RPO: حداکثر میزان از دست رفتن داده که کسبوکار میتواند تحمل کند و معمولاً بر اساس زمان بیان میشود.
Recovery Time Objective یا RTO: هدف زمانی برای بازگرداندن یک سرویس یا قابلیت پس از اختلال.
برای مثال، ممکن است یک فروشگاه اینترنتی RPO برابر با ۱۵ دقیقه و RTO برابر با دو ساعت تعیین کند.
این اعداد صرفاً نمونهاند و تحقق آنها به معماری، بودجه، زیرساخت و نتایج آزمون بازیابی بستگی دارد.
آزمایش نسخه پشتیبان
صرف مشاهده پیام «پشتیبانگیری موفق» کافی نیست.
باید بهصورت دورهای بررسی شود که فایلها و پایگاه داده واقعاً قابلبازیابی هستند و نسخه بازیابیشده عملکرد درستی دارد.
Incident Response در وردپرس چگونه انجام میشود؟
سایتهای وردپرسی بهدلیل استفاده از افزونهها، قالبها و سرویسهای متنوع، نیازمند توجه ویژه به وابستگیهای نرمافزاری و مدیریت دسترسی هستند.
یک برنامه پاسخ به رخداد مناسب برای وردپرس باید علاوه بر سرور، اجزای خود وردپرس را نیز پوشش دهد.
بررسی حسابهای مدیریتی
در زمان وقوع حادثه باید حسابهای دارای دسترسی Administrator و سایر نقشهای حساس بررسی شوند.
وجود حساب ناشناس، تغییر غیرمنتظره نقش کاربران یا فعالیت مدیریتی غیرمعمول ممکن است به بررسی بیشتر نیاز داشته باشد.
حسابهای مشکوک باید مطابق برنامه مهار مدیریت شوند.
بررسی افزونهها و قالبها
افزونهها و قالبها بخش مهمی از سطح حمله وردپرس را تشکیل میدهند.
در بررسی حادثه باید نسخهها، منشأ نصب، تغییرات اخیر و وضعیت پشتیبانی امنیتی آنها مشخص شود.
استفاده از نسخههای نامعتبر یا دستکاریشده نرمافزار میتواند خطرات جدی ایجاد کند.
بررسی فایلهای اصلی وردپرس
فایلهای هسته وردپرس باید با نسخههای معتبر و متناسب با نسخه نصبشده مقایسه شوند.
وجود تغییرات غیرمجاز در فایلهای اصلی میتواند نشانه آلودگی باشد.
البته تفاوت فایلها باید با درنظرگرفتن فرایندهای مجاز مدیریت و استقرار بررسی شود.
بررسی تنظیمات حساس
فایلهای پیکربندی، مجوزهای دسترسی، تنظیمات اجرای کد و ارتباط با پایگاه داده اهمیت زیادی دارند.
تغییرات غیرمنتظره در این بخشها ممکن است به تداوم دسترسی غیرمجاز کمک کنند.
مدیریت نشستها و کلیدهای امنیتی
در صورت تصاحب حساب یا احتمال سرقت نشست، لغو نشستهای فعال و بازبینی کلیدهای مرتبط با احراز هویت اهمیت دارد.
در وردپرس، تغییر کلیدها و Saltهای احراز هویت میتواند در بیاعتبارکردن کوکیهای احراز هویت قبلی نقش داشته باشد؛ اما باید اثر آن بر کاربران و سرویسهای متصل در نظر گرفته شود.
بررسی پایگاه داده وردپرس
برخی حملات به جای فایلهای سیستم، محتوای پایگاه داده را تغییر میدهند.
تغییرات غیرمجاز در حسابها، تنظیمات، محتوای صفحات و آدرسهای سایت ممکن است نشانه حادثه باشند.
پاکسازی پایگاه داده باید با احتیاط و پس از تهیه نسخه مناسب و تحلیل دامنه تغییرات انجام شود.
تقویت امنیت پس از بازیابی
پس از رفع حادثه، اقداماتی مانند بهروزرسانی وردپرس، حذف افزونههای بلااستفاده، فعالسازی 2FA، محدودکردن دسترسیها و بهبود مانیتورینگ توصیه میشوند.
هیچ افزونه امنیتی بهتنهایی نمیتواند جایگزین این مجموعه اقدامات شود.
برنامه Incident Response برای فروشگاههای ووکامرس
در فروشگاههای WooCommerce، پیامدهای حادثه امنیتی میتواند فراتر از تغییر صفحات سایت باشد.
اطلاعات مشتریان، سفارشها، وضعیت پرداخت و ارتباط با درگاههای مالی از داراییهای حساس فروشگاه هستند.
حفاظت از اطلاعات سفارشها
در صورت احتمال دسترسی غیرمجاز، باید مشخص شود چه اطلاعاتی مشاهده، تغییر یا استخراج شدهاند.
این بررسی میتواند شامل اطلاعات تماس مشتریان، آدرسها، تاریخچه سفارشها و دادههای مرتبط با تراکنش باشد.
بررسی یکپارچگی سفارشها
ممکن است حادثه باعث تغییر وضعیت سفارشها یا اختلال در ثبت تراکنشها شده باشد.
در زمان بازیابی، تطبیق سفارشها با اطلاعات معتبر درگاه پرداخت و سیستم حسابداری میتواند ضروری باشد.
بررسی ارتباط با درگاه پرداخت
اگر احتمال افشای کلیدهای API یا اعتبارنامههای درگاه وجود داشته باشد، باید با ارائهدهنده خدمات پرداخت هماهنگی شود.
در فروشگاههایی که دادههای پرداخت حساس را پردازش یا نگهداری میکنند، الزامات قراردادی و استانداردهای مرتبط مانند PCI DSS نیز ممکن است اهمیت داشته باشند.
جلوگیری از ازدسترفتن دادههای جدید
بازگرداندن یک نسخه پشتیبان قدیمی ممکن است موجب حذف سفارشهای ثبتشده پس از زمان تهیه پشتیبان شود.
به همین دلیل باید پیش از بازیابی، برنامه مشخصی برای تطبیق و حفظ دادههای معتبر جدید وجود داشته باشد.
بررسی چهار سناریوی واقعینما از پاسخ به رخداد سایت
برای درک بهتر کاربرد Incident Response، چهار سناریوی فرضی را بررسی میکنیم.
سناریوی اول: ایجاد حساب مدیر ناشناس
مدیر سایت متوجه میشود حسابی با دسترسی کامل ایجاد شده که هیچیک از اعضای تیم آن را نمیشناسند.
در این شرایط، تیم پاسخ ابتدا زمان ایجاد حساب و فعالیتهای مرتبط را بررسی میکند.
سپس بر اساس شدت تهدید، دسترسی حساب مشکوک محدود میشود و شواهد ضروری حفظ میگردند.
بررسی ادامه پیدا میکند تا مشخص شود حساب چگونه ایجاد شده و آیا تغییرات دیگری در سایت رخ داده است.
پس از اصلاح علت، اطلاعات احراز هویت و سیاستهای دسترسی بازبینی میشوند.
نتیجه: حذف حساب ناشناس بدون بررسی علت ایجاد آن، پاسخ کامل به حادثه نیست.
سناریوی دوم: هدایت کاربران به صفحات تبلیغاتی مشکوک
کاربران گزارش میدهند که بعضی صفحات سایت آنها را به دامنه دیگری هدایت میکنند.
تیم فنی ابتدا رفتار گزارششده را بهصورت کنترلشده تأیید میکند.
سپس فایلهای مرتبط، تنظیمات سایت، تغییرات پایگاه داده و گزارشهای دسترسی بررسی میشوند.
پس از شناسایی مسیر ایجاد تغییرات، اقدامات مهار انجام میشود و اجزای آلوده از منابع سالم بازسازی میشوند.
در پایان، صفحات مختلف و رفتار سایت از مسیرهای دسترسی متفاوت آزمایش میشوند.
نتیجه: حذف یک تغییر مسیر ظاهری، بدون شناسایی عامل ایجاد آن، ممکن است فقط نشانه حمله را پنهان کند.
سناریوی سوم: اختلال سایت در اثر DDoS
یک فروشگاه اینترنتی با افزایش شدید ترافیک و کاهش دسترسپذیری روبهرو میشود.
تیم پاسخ با کمک ارائهدهنده زیرساخت، الگوی ترافیک را بررسی میکند.
در صورت تأیید حمله، کنترلهای مناسب برای محدودسازی درخواستهای مخرب و حفظ دسترسی کاربران واقعی اعمال میشوند.
پس از تثبیت شرایط، ظرفیت زیرساخت و تنظیمات حفاظتی بازنگری میشوند.
نتیجه: هدف اصلی در این سناریو، حفظ دسترسپذیری سرویس و کاهش اثر حمله است؛ نه لزوماً پاکسازی بدافزار.
سناریوی چهارم: شناسایی فایل مخرب در هاست
ابزار نظارتی وجود یک فایل مشکوک را در فضای هاست گزارش میکند.
تیم فنی پس از بررسی اعتبار هشدار، وضعیت فایل، زمان ایجاد و ارتباط آن با سایر تغییرات را بررسی میکند.
در صورت تأیید آلودگی، دامنه دسترسی احتمالی مهاجم مشخص شده و اقدامات مهار انجام میشوند.
سپس فایلها و تنظیمات آسیبدیده از منابع معتبر بازسازی میشوند و علت ایجاد آلودگی اصلاح میگردد.
نتیجه: اسکن بدافزار ابزار تشخیص است، اما بهتنهایی جایگزین تحلیل حادثه و اصلاح علت نفوذ نمیشود.
مدیریت ارتباطات هنگام رخداد امنیتی
در بسیاری از حوادث، مشکل فقط فنی نیست.
کاربران ممکن است درباره امنیت حسابهای خود سؤال داشته باشند، کارکنان به اطلاعات عملیاتی نیاز داشته باشند و مدیریت نیز بخواهد میزان خسارت را بداند.
به همین دلیل، ارتباطات باید بخشی از برنامه پاسخ به رخداد باشد.
اطلاعرسانی داخلی
اعضای مسئول باید اطلاعات دقیق و بهروز درباره وضعیت حادثه، تصمیمهای اتخاذشده و اقدامات بعدی دریافت کنند.
بهتر است یک مرجع مشخص برای ثبت وضعیت حادثه وجود داشته باشد تا از انتشار اطلاعات متناقض جلوگیری شود.
اطلاعرسانی به کاربران
اگر اطلاعات کاربران تحتتأثیر قرار گرفته یا اقدامات امنیتی از سوی آنها ضروری باشد، اطلاعرسانی باید متناسب با شواهد و الزامات مربوط انجام شود.
در پیامها باید میان موارد تأییدشده و موضوعاتی که هنوز در حال بررسی هستند تفاوت وجود داشته باشد.
ملاحظات حقوقی
تعهدات اطلاعرسانی به نوع داده، محل فعالیت، قراردادها و قوانین حاکم وابستهاند.
بنابراین نمیتوان برای تمام سایتها یک مهلت قانونی ثابت تعیین کرد.
در حوادث مهم، بررسی موضوع با مشاور حقوقی و متخصص حفاظت از داده مناسب است.
پرهیز از افشای اطلاعات حساس
اطلاعرسانی نباید شامل اطلاعاتی باشد که به گسترش حمله یا سوءاستفاده بیشتر کمک کند.
همچنین از انتشار نام یا مشخصات مهاجم بدون شواهد معتبر باید خودداری شود.
تفاوت Incident Response، Disaster Recovery و Business Continuity
این سه مفهوم با یکدیگر ارتباط دارند، اما هدف آنها کاملاً یکسان نیست.
Incident Response
بر شناسایی و مدیریت رخداد امنیتی، کاهش آسیب، حذف تهدید و جلوگیری از تکرار تمرکز دارد.
Disaster Recovery
بازیابی پس از بحران یا DR روی بازگرداندن سیستمها، زیرساخت و دادهها پس از اختلال جدی متمرکز است.
Business Continuity
تداوم کسبوکار یا BC به حفظ فعالیتهای حیاتی سازمان در زمان بحران میپردازد؛ حتی اگر همه سیستمها هنوز بازیابی نشده باشند.
| ویژگی | Incident Response | Disaster Recovery | Business Continuity |
|---|---|---|---|
| هدف اصلی | مدیریت حادثه امنیتی | بازگرداندن سیستمها و دادهها | حفظ فعالیتهای ضروری |
| تمرکز | تهدید، شواهد و علت حادثه | زیرساخت و بازیابی | فرایندهای کسبوکار |
| زمان فعالسازی | هنگام رخداد امنیتی یا احتمال جدی آن | هنگام اختلال نیازمند بازیابی | هنگام تهدید تداوم فعالیت |
| نمونه | مهار نفوذ به وردپرس | بازیابی سرور سالم | استفاده از فرایند جایگزین ثبت سفارش |
یک برنامه امنیتی کامل باید این سه حوزه را هماهنگ کند.
چگونه برنامه پاسخ به رخداد را آزمایش کنیم؟
نوشتن برنامه بدون آزمایش عملی ممکن است باعث ایجاد احساس امنیت کاذب شود.
یکی از روشهای مناسب، برگزاری تمرین Tabletop Exercise یا تمرین سناریومحور است.
تمرین Tabletop چیست؟
در این تمرین، اعضای تیم با یک حادثه فرضی روبهرو میشوند و درباره تصمیمها و مراحل پاسخ گفتوگو میکنند.
برای مثال، سناریو میتواند این باشد که شرکت هاستینگ اعلام کرده فعالیت مشکوکی از یکی از سایتهای وردپرسی مشاهده شده است.
از تیم پرسیده میشود:
چه کسی موضوع را بررسی میکند؟ چه زمانی مدیر سایت مطلع میشود؟ چه اطلاعاتی از هاستینگ درخواست میشود؟ چه کسی درباره محدودسازی سرویس تصمیم میگیرد؟ چگونه از پاکسازی زودهنگام شواهد جلوگیری میشود؟
این تمرین به شناسایی ابهامهای برنامه کمک میکند.
آزمایش بازیابی
علاوه بر تمرین تصمیمگیری، لازم است بازگردانی نسخه پشتیبان در محیط آزمایشی انجام شود.
هدف آن است که مدتزمان واقعی بازیابی، مشکلات وابستگی و صحت عملکرد سرویس مشخص شود.
اصلاح برنامه پس از تمرین
نتایج هر تمرین باید ثبت و به اقدام اصلاحی تبدیل شود.
برای مثال، اگر مشخص شود تنها یک نفر به حساب هاستینگ دسترسی دارد، باید راهکار مناسبی برای دسترسی اضطراری مجاز در نظر گرفته شود.
شاخصهای سنجش کیفیت Incident Response
برای بهبود فرایند پاسخ به رخداد باید بتوان عملکرد آن را اندازهگیری کرد.
میانگین زمان تشخیص (MTTD)
Mean Time to Detect میانگین زمان لازم برای شناسایی حادثه از نقطه شروع تعریفشده است.
کاهش این شاخص معمولاً نشاندهنده بهبود قابلیت کشف است، اما تفسیر آن به کیفیت دادهها و نوع حوادث وابسته است.
میانگین زمان مهار (MTTC)
Mean Time to Contain مدتزمان متوسط موردنیاز برای محدودکردن اثر یک حادثه را نشان میدهد.
میانگین زمان پاسخ یا رفع مشکل (MTTR)
MTTR در سازمانهای مختلف ممکن است به Mean Time to Respond، Repair، Remediate یا Recover اشاره داشته باشد.
بنابراین هنگام استفاده از این شاخص باید تعریف دقیق نقطه شروع و پایان آن مشخص شود.
شاخصهای تکمیلی
شاخصهای زیر نیز میتوانند مفید باشند:
- درصد رخدادهای شناساییشده توسط مانیتورینگ داخلی
- درصد بازیابیهای موفق در تمرینها
- تعداد حوادث تکرارشونده
- درصد اقدامات اصلاحی تکمیلشده
- تعداد هشدارهای کاذب
- مدتزمان تصمیمگیری برای حوادث بحرانی
هدف از اندازهگیری نباید صرفاً تولید آمار باشد؛ بلکه باید به کاهش واقعی ریسک منجر شود.
اشتباهات رایج در Incident Response
حتی سازمانهایی که ابزارهای امنیتی مناسبی دارند، ممکن است هنگام حادثه تصمیمهای اشتباه بگیرند.
نداشتن برنامه پیش از وقوع حادثه
اگر مسئولیت افراد، اطلاعات تماس و مراحل پاسخ از قبل مشخص نباشد، زمان زیادی صرف هماهنگی خواهد شد.
حذف فوری فایلهای مشکوک
این اقدام ممکن است شواهد مهم را از بین ببرد یا مانع شناسایی دامنه آلودگی شود.
در موارد اضطراری، مهار میتواند مقدم باشد؛ اما باید متناسب با خطر و با ثبت تصمیمها انجام شود.
بازگردانی پشتیبان بدون بررسی سلامت
نسخه پشتیبان ممکن است شامل بدافزار یا تنظیمات آسیبپذیر باشد.
بنابراین باید بازه زمانی آلودگی و سلامت منبع بازیابی بررسی شود.
تغییر رمز عبور بدون بررسی سیستم
تغییر رمز عبور مفید است، اما در صورت وجود بدافزار فعال، دستگاه مدیریتی آلوده یا نشست معتبر سرقتشده، ممکن است بهتنهایی کافی نباشد.
اعتماد کامل به افزونه امنیتی
افزونهها بخشی از دفاع چندلایه هستند و نمیتوانند تمام تهدیدات مرتبط با سرور، حسابهای خارجی و خطاهای انسانی را پوشش دهند.
نادیدهگرفتن علت اصلی
اگر علت حمله رفع نشود، امکان وقوع مجدد حادثه باقی میماند.
بازگرداندن زودهنگام سایت
فشار برای فعالسازی سریع سرویس ممکن است باعث شود مرحله بررسی و تأیید امنیت نادیده گرفته شود.
نداشتن گزارش حادثه
بدون مستندسازی مناسب، پیگیری تصمیمها، تحلیل علت و بهبود فرایند دشوار خواهد شد.
فراموشکردن سرویسهای متصل
در یک حادثه امنیتی ممکن است سرویس ایمیل، DNS، فضای ابری یا سامانه استقرار نیز نیازمند بررسی باشد.
افشای اطلاعات تأییدنشده
اعلام قطعی علت حمله یا وضعیت اطلاعات کاربران بدون شواهد کافی میتواند پیامدهای حقوقی و اعتباری ایجاد کند.
چکلیست آمادگی سایت برای Incident Response
برای ارزیابی اولیه آمادگی سایت، موارد زیر را مرور کنید.
مدیریت و برنامهریزی:
- برنامه پاسخ به رخداد نوشته و تأیید شده باشد.
- مسئول اصلی و جانشین مشخص باشند.
- اطلاعات تماس اضطراری بهروز باشند.
- معیار اولویتبندی حوادث تعریف شده باشد.
- فرایند اطلاعرسانی داخلی و خارجی مشخص باشد.
کنترلهای فنی:
- نرمافزارهای مهم بهروز باشند.
- دسترسیها بر اساس حداقل مجوز تنظیم شده باشند.
- احراز هویت دومرحلهای برای حسابهای حساس فعال باشد.
- رویدادهای مهم امنیتی ثبت شوند.
- گزارشها در برابر تغییر غیرمجاز محافظت شوند.
- هشدارهای مهم به مسئول مشخص ارسال شوند.
- تنظیمات WAF و سایر کنترلهای حفاظتی بررسی شده باشند.
بازیابی و پشتیبانگیری:
- نسخههای پشتیبان مستقل وجود داشته باشند.
- سلامت نسخهها بهصورت دورهای آزمایش شود.
- اهداف RPO و RTO مشخص باشند.
- فرایند بازیابی مستند شده باشد.
- اطلاعات لازم برای بازیابی بدون وابستگی کامل به سایت اصلی در دسترس باشد.
آموزش و بهبود:
- اعضای تیم با نقش خود آشنا باشند.
- تمرینهای دورهای انجام شوند.
- رخدادهای گذشته تحلیل شوند.
- اقدامات اصلاحی دارای مسئول و زمانبندی باشند.
این چکلیست نقطه شروع مناسبی است، اما برای سایتهای حساس باید با ارزیابی ریسک اختصاصی تکمیل شود.
برنامه ۳۰، ۶۰ و ۹۰ روزه برای پیادهسازی Incident Response
برای کسبوکارهایی که هنوز برنامه مشخصی ندارند، پیادهسازی تدریجی میتواند عملیتر از طراحی یکباره ساختاری پیچیده باشد.
۳۰ روز اول: ایجاد آمادگی اولیه
در ماه نخست، داراییهای حیاتی، حسابهای مهم و وابستگیهای خارجی شناسایی شوند.
مسئول پاسخ به رخداد تعیین شود و اطلاعات تماس اضطراری جمعآوری گردد.
همچنین وضعیت نسخههای پشتیبان، دسترسیهای مدیریتی و ثبت گزارشهای امنیتی بررسی شود.
خروجی این دوره باید یک برنامه کوتاه و قابلاجرا برای حوادث مهم باشد.
روزهای ۳۱ تا ۶۰: تقویت کنترلهای امنیتی
در این مرحله، تنظیمات هشدارها، حفاظت از گزارشها، احراز هویت حسابهای حساس و روشهای بازیابی بهبود پیدا کنند.
سناریوهای مهمی مانند تصاحب حساب مدیر، آلودگی فایلها و اختلال سرویس نیز به برنامه اضافه شوند.
برای هر سناریو، مسئول تصمیمگیری و اقدامات اولیه مشخص شود.
روزهای ۶۱ تا ۹۰: آزمایش و اصلاح
در ماه سوم، یک تمرین سناریومحور برگزار شود و بازیابی سایت در محیط آزمایشی بررسی گردد.
سپس نقاط ضعف شناساییشده اولویتبندی شوند.
در پایان این دوره، سازمان باید حداقل یک برنامه مستند، مسیر ارتباط اضطراری، نسخه پشتیبان آزمایششده و روند مشخص برای بررسی هشدارهای مهم داشته باشد.
این جدول زمانی پیشنهادی است؛ سایتهای دارای دادههای بسیار حساس یا تهدید فعال ممکن است به اقدامات فوریتری نیاز داشته باشند.
آینده Incident Response و نقش هوش مصنوعی
با افزایش پیچیدگی زیرساختها و حجم دادههای امنیتی، ابزارهای خودکار و هوش مصنوعی نقش بیشتری در فرایند پاسخ به رخداد پیدا کردهاند.
تحلیل خودکار هشدارها
سامانههای تحلیلی میتوانند به دستهبندی هشدارها، یافتن ارتباط میان رویدادها و شناسایی الگوهای غیرمعمول کمک کنند.
استفاده از SOAR
Security Orchestration, Automation and Response یا SOAR مجموعهای از قابلیتهای هماهنگسازی و خودکارسازی گردشکارهای امنیتی است.
برای مثال، یک سامانه SOAR میتواند اطلاعات هشدار را از چند ابزار دریافت کند و مراحل بررسی یا ارجاع را طبق سیاستهای تعریفشده آغاز کند.
محدودیتهای خودکارسازی
تصمیمهای حساس مانند قطع سرویس، حذف داده یا تغییر گسترده دسترسیها نباید بدون کنترل مناسب به ابزارهای خودکار سپرده شوند.
هشدار کاذب، داده ناقص و خطای تحلیل میتوانند پیامدهای عملیاتی جدی داشته باشند.
بنابراین استفاده از هوش مصنوعی باید همراه با نظارت انسانی، ثبت تصمیمها و محدودسازی مجوزهای ابزارها باشد.
سؤالات متداول درباره Incident Response
Incident Response چیست و چه کاربردی دارد؟
Incident Response فرایند مدیریت رخدادهای امنیتی از زمان شناسایی تا مهار، پاکسازی، بازیابی و تحلیل پس از حادثه است. این فرایند کمک میکند اثر حملات سایبری کاهش پیدا کند و سازمان بتواند خدمات خود را به شکل امن بازگرداند.
آیا سایتهای کوچک هم به برنامه Incident Response نیاز دارند؟
بله. حتی یک وبسایت کوچک ممکن است با سرقت حساب مدیر، آلودگی فایلها یا اختلال زیرساخت مواجه شود. البته برنامه پاسخ باید متناسب با اندازه سایت و منابع موجود طراحی شود و نیازی به ساختار پیچیده سازمانی ندارد.
مهمترین مرحله Incident Response کدام است؟
تمام مراحل اهمیت دارند، اما آمادگی پیش از حادثه نقش اساسی در موفقیت سایر مراحل دارد. بدون گزارشهای مناسب، نسخه پشتیبان و مسئولیتهای مشخص، شناسایی و بازیابی معمولاً دشوارتر میشود.
آیا نصب افزونه امنیتی وردپرس برای پاسخ به رخداد کافی است؟
خیر. افزونه امنیتی ممکن است قابلیتهایی مانند پایش، هشدار یا کنترل دسترسی فراهم کند، اما بررسی علت حادثه، حفظ شواهد، مدیریت حسابهای خارجی و بازیابی کامل نیازمند فرایندی گستردهتر است.
بعد از هک سایت، ابتدا چه کاری باید انجام دهیم؟
ابتدا نشانهها و زمان مشاهده حادثه را ثبت کنید، شدت خطر را ارزیابی کنید و مسئول پاسخ را مطلع سازید. سپس با توجه به شرایط، شواهد مهم حفظ و اقدامات مهار مناسب انجام شوند. از حذف یا تغییر شتابزده اطلاعات بدون بررسی پیامدها خودداری کنید.
آیا بازگردانی بکاپ باعث پاکشدن کامل بدافزار میشود؟
لزوماً خیر. اگر نسخه پشتیبان آلوده باشد یا عامل اصلی نفوذ همچنان وجود داشته باشد، امکان تکرار مشکل وجود دارد. بازیابی امن مستلزم انتخاب منبع سالم، رفع علت حادثه و بررسی دسترسیهای غیرمجاز است.
تفاوت Incident Response و Incident Management چیست؟
Incident Management اصطلاحی گستردهتر برای مدیریت انواع اختلالها و حوادث عملیاتی است. Incident Response در حوزه امنیت سایبری بر شناسایی و مقابله با رخدادهای امنیتی تمرکز دارد. البته در عمل، فرایندهای این دو حوزه میتوانند همپوشانی داشته باشند.
آیا WAF میتواند مانع تمام حملات سایبری شود؟
خیر. WAF میتواند برخی درخواستهای مخرب وب را شناسایی یا محدود کند، اما تهدیداتی مانند سرقت اعتبارنامهها، تنظیمات اشتباه، آسیبپذیریهای ناشناخته و مشکلات امنیتی سرویسهای خارجی به کنترلهای تکمیلی نیاز دارند.
تیم CSIRT چه وظیفهای دارد؟
CSIRT مسئول هماهنگی و اجرای فعالیتهای مرتبط با رسیدگی به رخدادهای امنیتی است. این فعالیتها میتوانند شامل دریافت گزارش، تحلیل شواهد، هماهنگی مهار، پشتیبانی از بازیابی و ارائه پیشنهادهای اصلاحی باشند.
Incident Response Plan هر چند وقت یکبار باید بررسی شود؟
تناوب بازبینی به اندازه سازمان، حساسیت سرویس و میزان تغییرات محیط بستگی دارد. بهعنوان یک رویه مناسب، برنامه باید حداقل بهصورت دورهای و همچنین پس از رخداد مهم، تغییر زیرساخت یا تمرین عملی بازبینی شود.
چه زمانی باید از متخصص پاسخ به رخداد کمک بگیریم؟
وقتی احتمال افشای اطلاعات حساس، دسترسی گسترده مهاجم، آلودگی چند سیستم یا نبود توان فنی کافی برای بررسی وجود دارد، استفاده از متخصص مناسب است. در حوادث دارای پیامد حقوقی، همکاری با مشاور حقوقی نیز ممکن است ضروری باشد.
آیا Incident Response از حمله جلوگیری میکند؟
هدف اصلی Incident Response مدیریت مؤثر حوادث است، نه تضمین جلوگیری از تمام حملات. بااینحال، آمادگی، تحلیل علت ریشهای و اصلاح کنترلهای امنیتی پس از حادثه میتوانند احتمال تکرار رخدادهای مشابه را کاهش دهند.
هزینه پیادهسازی Incident Response چقدر است؟
هزینه به ابعاد زیرساخت، حساسیت اطلاعات، تعداد سیستمها و نیاز به خدمات تخصصی بستگی دارد. در یک سایت کوچک میتوان با مستندسازی، پشتیبانگیری، ثبت رویدادها و تعریف مسئولیتها شروع کرد. سازمانهای بزرگ معمولاً به ابزارها و نیروی تخصصی بیشتری نیاز دارند.
جمعبندی: آمادگی برای حمله، بخش ضروری امنیت سایت است
Incident Response یا پاسخ به رخداد امنیتی یکی از مهمترین بخشهای مدیریت امنیت وبسایت است. این فرایند کمک میکند هنگام وقوع حادثه، تصمیمها براساس شواهد، اولویتهای مشخص و برنامهای از پیش تعیینشده اتخاذ شوند.
برای داشتن یک برنامه مؤثر، باید پیش از وقوع حمله داراییهای مهم را شناسایی کنید، مسئولیت افراد را مشخص کنید، ثبت رویدادهای امنیتی را فعال نگه دارید و از نسخههای پشتیبان سالم و آزمایششده استفاده کنید.
در زمان وقوع حادثه نیز شناسایی دقیق، مهار متناسب با خطر، حفظ شواهد، رفع علت اصلی و بازیابی کنترلشده اهمیت زیادی دارند.
برای سایتهای وردپرسی و فروشگاههای ووکامرس، توجه به حسابهای مدیریتی، افزونهها، اطلاعات مشتریان، سرویسهای پرداخت و وابستگیهای زیرساختی ضروری است.
همچنین فراموش نکنید که امنیت یک وضعیت ثابت نیست. تهدیدات، نرمافزارها و شرایط کسبوکار تغییر میکنند و برنامه پاسخ به رخداد نیز باید همراه با آنها تکامل پیدا کند.
مهمترین اصل این است: زمان مناسب برای طراحی برنامه Incident Response، پیش از وقوع حمله است؛ نه زمانی که سایت از دسترس خارج شده یا اطلاعات کاربران در معرض خطر قرار گرفته است.
با تهیه یک برنامه قابلاجرا، آموزش اعضای تیم، آزمایش بازیابی و اصلاح مستمر نقاط ضعف، میتوان توانایی سایت را برای مقابله با حوادث امنیتی به شکل محسوسی افزایش داد.
مطالب مرتبط